리눅스 Tips, 리눅스 C/C++ 프로그래밍, 모바일 클라우드 동향 및 테스트 등

  Welcome to my Blog!

 °Name : KWON HAN SEUNG
 °Interested in
   - Linux
   - Mobile Cloud
   - Image Processing
   - Signal Processing

 Facebook Link...
 Univ. Team Link...

2013년 4월 26일 금요일

네트워크 기본이론 : 06 스위치를 켜라(1)


1. 스위치와 브리지

 - 스위치 또는 브리지는 콜리전 도메인을 나누어 주는 장비이다.
 - 브리지와 스위치는 둘다 데이터 링크 레이어이지만 다음과 같은 차이점이 존재한다.
  1) 스위치는 하드웨어 방식으로, 브리지는 소프트웨어 방식으로 프레임을 처리한다.
  2) 브리지는 포트들이 같은 속도를 지원하지만, 스위치는 서로 다른 속도를 연결해줄 수 있는 기능을 제공한다.
  3) 스위치는 브리지에 비해 제공하는 포트 수가 훨씬 많다.
  4) 스위치의 경우 cut-through 또는 store-and-forward 방식을 사용하는데 비해서 브리지는 오로지 store-and-forward 방식만을 사용한다.

2. 본격적으로 스패닝 트리를 공부하기 전에

 - 스패닝 트리 알고리즘이란 스위치나 브리지에서 발생하는 루핑을 막기 위한 프로토콜이다.
 - 스패닝 트리 프로토콜을 이해하기 위해 다음과 같은 두 가지 개념을 이해할 필요가 있다.
  1) 브리지 ID
    - 브리지나 스위치들이 통신할 때 서로의 확인을 위해 하나씩 가지고 있는 번호
    - Bridge Priority(2byte) + MAC Address(6byte) 로 구성되어 있음
    - 디폴트 값은 중간값인 32768
  2) Path Cost
    - 브리지가 얼마나 가까이, 그리고 빠른 링크로 연결되어 있는지를 알아내기 위한 값
    - (Bandwidth - Path Cost) : (10Mbps - 100), (100Mbps - 19), (1Gbps - 4)

3. 본격적으로 스패닝 트리를 공부하기 전에

 - 스패닝 트리를 이해하기 위해 외어야 할 기본 동작 세가지는 다음과 같다.
  1) 네트워크당 하나의 루트 브리지(Root Bridge)를 갖는다.
  2) 루트 브리지가 아닌 모든 브리지(Non Root Bridge)는 무조건 하나씩의 루트 포트(Root Port)를 갖는다.
  3) 세그먼트(Segment) 당 하나씩의 데지그네이티드 포트(Designated Port)를 갖는다.
    * 스패닝 트리 프로토콜에서 루트 포트, 데지그네이티드 포트를 제외한 모든 포트는 막는다.

4. STP(Spanning Tree Protocol)에서 힘 겨루기

 - 루트 브리지, 루트 포트, 데지그네이티드 포트를 정하기 위한 4가지 단계는 다음과 같다.
  1) 누가 더 작은 Root BID를 가졌는가?
  2) 루트 브리지까지의 Path Cost 값은 누가 더 작은가?
  3) 누가 더 작은 Sender BID를 가졌는가?
  4) 누구의 Port ID가 더 낮은가?
 - 스패닝 트리 정보를 주고받기 위해 BPDU(Bridge Protocol Data Unit)이라는 특수한 프레임을 사용하며, 2초마다 주고받는 BPDU에는 Root BID, Path Cost, Sender BID, Port ID 등의 정보가 실려있다.

5. Root Bridge 선정하기

 - 다음은 루트 브리지 선정 Flow이다.
  1) 스위치(브리지) 부팅
  2) BPDU 프레임 주고받기(Root BID, Sender BID 모두 자신의 BID 값)
  3) 전달 받은 BPDU 프레임에서 BID 값을 비교하여 낮은 값의 브리지가 루트 브리지
  4) 루트 브리지가 아닌 스위치(브리지)의 BPDU에서 Root BID값을 선정된 루트 브리지 값으로 대체
 - 강제적으로 다른 스위치(브리지)를 루트 브리지로 선정하고 싶은 경우에는 BID의 Bridge Priority 값을 낮은 값으로 변경하면 된다.

6. Root Port 선정하기

 - 다음은 루트 포트 선정 Flow이다.
  1) 루트 브리지가 아닌 스위치(브리지)의 각 포트에서 루트 브리지까지의 Path Cost 비교
  2) 각 스위치(브리지)에서 가장 낮은 Root Path Cost를 가진 포트가 루트 포트로 선정

7. Designated Port 선정하기

 - 세그먼트(Segment) 당 하나씩의 데지그네이티드 포트를 지님을 기억하자.
 - 다음은 데지그네이티드 포트 선정 Flow이다.
  1) 루트 브리지의 포트는 모두 데지그네이티드 포트
  2) 루트 브리지가 아닌 스위치 사이에 생성된 세그먼트에서는 Root BID, Root Path Cost, Sender BID, Port ID 값을 순서대로 비교하여 낮은 값을 지닌 포트가 데지그네이티드 포트 선정

8. 스패닝 트리 프로토콜의 5가지 상태 변화

 - STP의 구현 과정에서 모든 스위치(브리지)들의 포트들은 다음의 5가지 상태로 변화한다.
  1) Disabled : 포트 고장, 관리자가 포트를 Shut Down 시킨 상태
    - 데이터 전송 : 불가능
    - MAC Address Learning : 불가능
    - BPDU 전송 :  불가능
  2) Blocking : 스위치를 처음 켜거나 Shut Down 상태의 포트를 살린 경우로 BPDU 전송을 통해 루트 브리지, 루트 포트, 데지그네이티드 포트 선정이 이 단계에서 이루어짐
    - 데이터 전송 : 불가능
    - MAC Address Learning : 불가능
    - BPDU 전송 :  가능
  3) Listening : 블로킹 상태에서 루트 브리지, 루트 포트, 데지그네이티드 포트 선정이 완료된 상태로 네트워크 상황에 따라 다시 블로킹 상태로 되돌아 갈 수 있음
    - 데이터 전송 : 불가능
    - MAC Address Learning : 불가능
    - BPDU 전송 :  가능
  4) Learning : 리스닝 상태를 포워딩 딜레이인 15초 동안 유지하면 러닝 상태로 변경되며, 맥 어드레스 테이블을 만드는 작업을 수행하는 단계
    - 데이터 전송 : 불가능
    - MAC Address Learning : 가능
    - BPDU 전송 :  가능
  5) Forwarding : 러능 상태를 포워딩 딜레이인 15초 동안 유지하면 포워딩 상태로 변경되며, 이때부터 데이터 프레임 전송이 가능
    - 데이터 전송 : 가능
    - MAC Address Learning : 가능
    - BPDU 전송 :  가능
 * 리스닝, 러닝, 포워딩 상태에 있던 포트도 루트 포트나 데지그네이티드 포트에서 탈락되면 바로 블로킹 상태로 넘어갈 수 있으며, 고장이나 Shut Down 여부에 따라서도 디스에이블드 상태로 넘어갈 수 있다.

9. 스패닝 트리의 변화

 - 링크의 속도와 루트 브리지를 어디로 잡느냐의 여부를 항상 염두해서 네트워크를 디자인
 - 스패닝 트리의 변화를 공부함에 앞서 알아야할 용어
  1) Hello Time : 루트 브리지가 헬로 BPDU를 보내는 시간 간격으로 디폴트는 2초
  2) Max Age : 브리지들이 루트 브리지로부터 얼마 동안 헬로 BPDU를 받지 못했을 때 루트 브리지가 죽었다고 생각하고 새로운 스패닝 트리를 만들기 시작하는가에 대한 시간으로 디폴트는 20초
  3) Forwarding Delay : 브리지 포트가 리스닝 상태에서 러닝 상태로, 러닝 상태에서 포워딩 상태로 바뀌는데 걸리는 시간으로 디폴트는 각 15초

'네트워크 기본이론 : 06 스위치를 켜라(2) '에 이어서...

2013년 4월 10일 수요일

네트워크 기본이론 : 05 IP 주소로의 여행

1. 라우터와 IP 주소

 - 라우터에서
  1) 이더넷 인터페이스 : 내부 네트워크에 연결되는 라우터의 포트로 내부에서 사용하기 위해 부여 받은 IP 주소 중 하나를 배정해야 한다. 이러한 IP 주소는 보통 맨 앞의 번호를 쓰게 되는데, 예를 들어 내부 PC용으로 부여 받은 주소가 203.120.150.1~203.120.150.255까지라면 라우터는 203.120.150.1을 사용하는 것이 보편적이다.
  2) 시리얼 인터페이스 : 외부 네트워크(인터넷)에 연결되는 라우터의 포트로 DSU 또는 CSU라는 전용선 모뎀에 연결된다. 시리얼 인터페이스도 이더넷 인터페이스 처럼 IP 주소를 부여해야 하는데 이는 마음대로 정하는 것이 아니라 라우터가 접속하는 상대편(ISP) 라우터의 시리얼 인터페이스와 IP 주소를 서로 맞추어 부여해야 한다.

 - 라우터에서 인터페이스가 달라진다는 것은 네트워크가 달라진다는 것을 의미한다.
 - IP 주소는 TCP/IP 프로토콜을 사용하는 모든 장비들을 구분하기 위해 만들어진 32자리의 2진수이다.
 - 32자리의 2진수로 이루어진 IP 주소는 네트워크 부분과 호스트 부분으로 나뉘고, 어떻게 나누었는지에 따라 5종류의 Class 중 하나가 된다.
  1) 네트워크 부분 : 하나의 브로드캐스트 영역으로 하나의 PC가 데이터를 뿌렸을 때 그 데이터를 라우터를 거치지 않고 바로 받을 수 있는 영역이다.
  2) 호스트 부분 : 각각의 PC 또는 장비를 뜻하며, 다른 장비가 같은 주소를 부여 받아서는 안된다. 예를 들어 내부 PC용으로 부여 받은 주소가 203.120.150.1~203.120.150.255까지라면 203.120.150 부분이 네트워크 부분, 나머지 부분이 호스트 부분이 된다.

 - 참고로 IP 주소 중에 네트워크 부분만이 라우터가 라우팅 할 때 참고하는 부분이다.
 - 다음은 IP주소의 Class를 나타낸다. 이와 같은 Class는 IP 주소를 효율적으로 배분하기 위해 사용된다.
  1) Class A : 다음과 같이 32개의 이진수 중에서 맨 앞쪽 하나가 항상 0으로 시작되는 것들
                              0xxx xxxx . xxxx xxxx . xxxx xxxx . xxxx xxxx
                      클래스 A의 경우 앞의 8비트가 네트워크 부분을 나타내고 나머지 24비트가 호스트 부분을 나타낸다.  또한 네트워크 부분의 경우 가장 작은 네트워크(0.0.0.0)와 가장 큰 네트워크(127.0.0.0)는 네트워크에서 제외 되므로 1.0.0.0~126.0.0.0을 네트워크 부분으로 가지며, 호스트 부분의 경우 모두 0인 경우(네트워크 자체를 나타내므로)와 모두 1인 경우(브로트캐스트 주소이므로)는 제외 되므로 (2^24-2)가 호스트의 수가 된다.
  2) Class B : 다음과 같이 32개의 이진수 중에서 맨 앞이 반드시 10(2진수)으로 시작되는 것들
                              10xx xxxx . xxxx xxxx . xxxx xxxx . xxxx xxxx
                      클래스 B의 경우 앞의 16비트가 네트워크 부분을 나타내고 나머지 16비트가 호스트 부분을 나타낸다.  또한 네트워크 부분의 경우 가장 작은 네트워크(128.0.0.0)와 가장 큰 네트워크(191.255.0.0)는 네트워크에서 제외 되므로 128.1.0.0~191.254.0.0을 네트워크 부분으로 가지며, 호스트 부분의 경우 모두 0인 경우(네트워크 자체를 나타내므로)와 모두 1인 경우(브로트캐스트 주소이므로)는 제외 되므로 (2^16-2)가 호스트의 수가 된다.
  3) Class C : 다음과 같이 32개의 이진수 중에서 맨 앞이 항상 110(2진수)으로 시작되는 것들
                              110x xxxx . xxxx xxxx . xxxx xxxx . xxxx xxxx
                      클래스 C의 경우 앞의 24비트가 네트워크 부분을 나타내고 나머지 8비트가 호스트 부분을 나타낸다.  또한 네트워크 부분의 경우 가장 작은 네트워크(192.0.0.0)와 가장 큰 네트워크(223.255.255.0)는 네트워크에서 제외 되므로 192.0.1.0~223.255.254.0을 네트워크 부분으로 가지며, 호스트 부분의 경우 모두 0인 경우(네트워크 자체를 나타내므로)와 모두 1인 경우(브로트캐스트 주소이므로)는 제외 되므로 (2^8-2)가 호스트의 수가 된다.
  4) Class D 와 Class E : 멀티캐스트용, 연구 개발용

 - 네트워크가 서로 다른 두 장비 간의 통신은 라우터를 통해서만 가능하다. 앞서 언급하였듯이 라우터의 각 인터페이스에는 해당 인터페이스가 속한 네트워크의 IP 주소를 부여해야 하며(사실 스위치나 허브에 IP 주소를 배정하지 않아도 통신에는 지장이 없지만 관리를 위해서 부여하는 것이 좋다),  IP 주소를 배정할 때는 접속 가능한 호스트의 수 등을 파악해야 한다.
 - 기본 게이트 웨이란 내부 네트워크에서 없는 녀석을 찾을 때 밖으로 통하는 문이 되는 것으로 라우터의 이더넷 인터페이스가 된다.

2. 서브넷 마스크

 - 서브넷 마스크란 메인이 아닌 어떤 가공을 통한 네트워크를 만들기 위해서 씌우는 마스크로 주어진 IP 주소를 네트워크 환경에 맞게 나누어 주기 위해서 씌워주는 2진수 조합이다.
 - 라우터를 통해서 큰 네트워크에 서브넷 마스크를 씌워 네트워크를 나누어 줄 수 있으며, 이는 네트워크(브로드캐스트 도메인)가 너무 커서 발생하는 통신 문제를 해결할 수 있도록 한다.
 - 서브넷 마스크는 네트워크를 나누었는지 여부를 판단하기 위하여, 네트워크를 나누지 않더라도 항상 사용된다. 이때 사용되는 서브넷 마스크를 디폴트 서브넷 마스크라 하며 클래스에 따라 다음과 같이 나타낸다.
  1) Default Subnet Mask_Class A : 255 . 0 . 0 . 0
  2) Default Subnet Mask_Class B : 255 . 255 . 0 . 0
  3) Default Subnet Mask_Class C : 255 . 255 . 255 . 0

 - 서브넷 마스크는 이진수로 썼을 때 반드시 '1'이 연속적으로 나와야 한다.
 - 서브넷 마스크는 서브넷의 IP 주소에서 네트워크 부분과 호스트 부분을 판단할 수 있도록 해주며, 여기에서 서브넷은 서브넷 마스크를 통해서 나뉘어진 각각의 네트워크를 말한다. 각각의 서브넷 끼리의 통신은 라우터를 통해서만 가능하다. 추가적으로 라우터 없이 네트워크를 나누기 위해 서브넷 마스크를 만들어서 쓴다는 말은 틀린 말이다.
 * 콜리전 도메인을 나누는 것이 스위치,
    브로드캐스트 도메인을 나누는 것이 라우터이다.
 - 예를 들어 150.100.0.0이란 클래스 B 네트워크를 255.255.255.0이란 서브넷 마스크를 사용해서 서브네팅을 했을 경우. 150.100.100.1과 150.100.200.1은 서로 다른 네트워크에 속한 호스트가 된다. 즉 서로 다른 브로드캐스트 도메인에 존재하고 있기 때문에 라우터를 통해서만 통신이 가능하다.
 - 서브넷을 실제로 나누는 예를 살펴보자. 210.100.1.0란 클래스 C 네트워크를 받았을 때, PC 30대인 네트워크를 최소 4개 이상 만든다고 하자. 여기서 주의할 점은 서브넷을 통해서 네트워크를 나누었을 때 각 네트워크에서 호스트 부분이 전부 0인 경우(네트워크 자체)와 전부 1인 경우(브로드캐스트 주소)는 사용할 수 없으며, 이에 따라 사용 가능한 호스트 수는 '2^(호스트 비트 수) - 2' 라는 것이다. 따라서 호스트 수 30개가 되기 위해서는 호스트 자리 수가 이진수 5개가 되며, 서브넷 마스크는 255.255.255.224가 되는 것이다.

네트워크 기본이론 : 04 네트워크 장비들에 관한 이야기

1. 랜카드(NIC)

 - NIC는 Network Interface Card의 약자로 보통 랜카드라고 부른다.
 - 랜카드는 유저의 데이터를 케이블에 실어서 허브나 스위치, 혹은 라우터 등으로 전달해주고 자신에게 온 데이터를 CPU에게 전달해 주는 역할을 한다.
 - 랜카드의 분류
  1) 네트워크 환경에 따라
   a. 이더넷용 : 대부분의 환경에서는 이더넷을 사용
   b. 토큰링용
   c. FDDI용
   d. AMT용
  2) PC의 버스 방식에 따라
   a. PCI용 : 현재 가장 많이 사용
   b. ISA용
   c. EISA용 : 간혹 서버급에서 사용
  3) 속도에 따라 : 실제 상황에서는 인캡슐레이션, 오버헤드에 의해 제 속도가 나오지 않는다.
   a. 10Mbps용
   b. 100Mbps용
   c. 10-100 Auto-sense용
  4) 케이블의 종류에 따라
   a. UTP용 : 일반적임
   b. BNC용
   c. AUI용
   d. 광케이블용
 - 장치관리자 -> 네트워크 어댑터에서 랜카드에 대한 등록정보에서 리소스 항목을 살펴보면, 입/출력 범위, 인터럽트 요청(IRQ), 메모리 범위(Base Memory) 등이 나타난다. 이러한 값들은 내가 목적지인 데이터가 들어왔을 떄 랜카드는 컴퓨터의 CPU에게 자기가 가지고 있던 IRQ를 이용하여 인터럽트를 걸게 되고, CPU는 IRQ번호를 확인하고 랜카드에서의 서비스 요청임을 확인, 그리고 이 데이터에게 어떤 서비스를 제공할 것인지를 미리 정해 놓은 장소인 Base Memory로 이동하여 작업을 시작하게 된다.

2. 허브(HUB)

 - 연결된 모든 PC들이 서로 통신할 수 있게 해주는 역할을 하는 장비로, 멀티포트 리피터(Multiport Repeater)라고도 한다. 이는 포트가 여러 개 달린 장비인데, 이것은 한 포트로 들어온 데이터를 나머지 모든 포트로 뿌려준다는 것이다.
 - 허브는 랜카드 처럼 이더넷용, 토큰링용 등으로 나뉘고, 포트 수에 따라, 속도에 따라서도 종류가 나뉜다.
 - 허브의 설치는 전원에 연결하고 스위치를 켜면 OK!
 - 이더넷 허브의 경우 이더넷의 특징인 CSMA/CD의 적용을 받는다. 따라서 하나의 PC가 허브에 데이터를 보내고 있을 때 또 다른 PC가 데이터를 보내려고 하면 콜리전이 발생한다. 따라서 같은 허브에 열결되어 있는 모든 PC들은 모두 '같은 콜리전 도메인 상에 있다'(Shared 방식 허브)라고 말한다.
 - 허브를 계속해서 연결해 나갈수록 콜리전 도메인의 크기는 점점 커지게 되고, 콜리전에 영향을 받는 PC들이 많아지므로 속도가 감소한다.
 - 허브의 종류
  1) 인텔리전트 허브 : 지능형 허브로 NMS(네트워크 관리시스템)을 통해 데이터 분석 및 제어
  2) 더미 허브 : 일반적인 허브
  3) 세미 인텔리전트 허브 : 일단은 더미 허브이나, 인텔리전트 허브와 연결하면 인텔리전트 허브가 됨

3. 브리지와 스위치

 - 허브의 콜리전 도메인에 따른 문제를 해결하기 위해 콜리전 도메인을 나누어 줄 수 있는 장비가 탄생하였는데, 바로 브리지(Bridge) 또는 스위치(Switch)이다.
 - 스위치는 허브에 비해서 데이터 처리 방법이 우수할 뿐만 아니라 전송 에러 등을 복구해주는 등 다양한 기능을 가진다.
 - 스위치는 임의의 두 포트 사이에서 통신이 일어나면 나머지 모든 PC들은 기다려야 했던 허브와는 달리 다른 PC들도 동시에 통신이 가능하며 이를 '포트별로 콜리전 도메인이 나뉘어 있다' 혹은 '각각의 포트에 연결된 PC가 독자적으로 10Mbps 또는 100Mbps의 속도를 갖는다'라고 말한다.
 - 브리지나 스위치는 다음 다섯 가지 일을 한다.
  1) Learning : 들어오는 프레임에 대해서 출발지의 맥 어드레스를 세그먼트 별로 브리지 테이블에 저장한다.
  2) Flooding : 들어온 프레임의 목적지 주소가 브리지 테이블에 없는 경우 들어온 포트를 제외한 나머지 모든 포트로 프레임을 뿌려준다.
  3) Forwarding : 들어온 프레임의 목적지 주소가 브리지 테이블에 존재하며, 목적지가 출발지와 다른 세그먼트에 존재하는 경우 프레임을 해당 포트쪽으로만 뿌려준다.
  4) Filtering : 들어온 프레임의 목적지 주소가 브리지 테이블에 존재하며, 목적지가 출발지와 같은 세그먼트에 존재하는 경우 브리지(또는 스위치)는 다른 포트들을 막는다. 이를 통해 콜리전 도메인을 나눌 수 있게 되는 것이다.
  5) Aging : 브리지 테이블의 기억 용량 및 시간은 한정되어 있다. 따라서 어떤 맥 어드레스를 브리지 테이블에 저장하고 나면 그때부터 Aging기능이 가동되어 저장 후 300초가 지나도록 더 이상 그 출발지 주소를 가진 프레임이 들어오지 않으면 브리지 테이블에서 해당 맥 어드레스를 삭제한다. 만약 300초 이내에 똑같은 출발지 주소의 프레임이 들어오면 Aging 타이머를 리플래시 한다.
 - 브리지와 스위치는 둘다 데이터 링크 레이어이지만 다음과 같은 차이점이 존재한다.
  1) 스위치는 하드웨어 방식으로, 브리지는 소프트웨어 방식으로 프레임을 처리한다.
  2) 브리지는 포트들이 같은 속도를 지원하지만, 스위치는 서로 다른 속도를 연결해줄 수 있는 기능을 제공한다.
  3) 스위치는 브리지에 비해 제공하는 포트 수가 훨씬 많다.
  4) 스위치의 경우 cut-through 또는 store-and-forward 방식을 사용하는데 비해서 브리지는 오로지 store-and-forward 방식만을 사용한다.
   . store-and-forward : 일단 프레임을 전부 받아들인 다음 제대로 다 들어왔는지, 에러는 없는지, 출발지 주소와 목적지 주소는 어디인지를 파악해서 처리해주는 방식으로 에러 발견시 재전송을 요구하기 때문에 에러 복구능력이 뛰어나다.
   . cut-through : 스위치가 들어오는 프레임의 목적지 주소만을 본 다음 바로 전송 처리를 하는 방식으로 프레임의 처음 48비트만을 보기 때문에 빠른 처리가 가능하지만 에러 복구능력이 떨어진다.
   . fragment-free : 앞의 두 방식의 장점을 결합한 방식으로 프레임의 처음 512비트를 보는 방식이다. 에러 감지 능력이 cut-through에 비해서 뛰어나다고 볼 수 있다.

4. Looping & Spanning Tree Algorithm

 - Looping은 하나의 호스트에서 다른 호스트로 가는 경로가 두개 이상인 경우 프레임이 네트워크 상에서 무한정으로 도는 현상을 말한다.
 - Looping을 자동적으로 막아주는 알고리즘인 스패닝 트리 알고리즘이 존재한다. 스패닝 트리 알고리즘은 스위치나 브리지에서 발생할 수 있는 루핑을 미리 막기 위해 두 개 이상의 경로가 발생하면 하나를 제외하고 나머지 경로들을 자동으로 막아두었다가 만약 기존 경로에 문제가 생기면 막아놓은 경로를 풀어서 데이터를 전송하는 알고리즘이다.
 - 위의 경우에서 만약 문제가 발생하여 현재의 링크가 끊어졌을 때 대기하고 있던 다른 링크가 다시 살아나서 연결을 해주는데 약 1분이 걸린다. 요즘에는 이러한 문제를 해결하기 위해 여러개의 링크를 마치 하나의 링크처럼 인식하게 하는 기술인 시스코의 이더 채널(Ether-Channel)이나 업링크 패스트(Uplink Fast)라는 기술을 사용한다.

*폴트 톨러런트 : 네트워크 상에 어떤 문제가 발생할 때를 대비해서 미리 장애 대비를 하는 것.
*로드 밸런싱 : 네트워크의 로드를 분산하여 성능 향상의 효과를 보는 것.
  -> 대부분의 로드 밸런싱은 폴트 톨러런트가 가능하지만 폴트 톨러런트는 로드 밸런싱이 안되는 경우도 있다.

5. 라우팅? 스위칭?

 - 스위치는 브로드캐스트에서 한계를 보인다. 따라서 브로드캐스트 영역(도메인)을 나누는 것은 매우 중요한 일이며 이를 위해서는 라우터가 반드시 필요하다.
 - 라우터는 스위치가 보장 못하는 보안 기능, 즉 패킷 필터링 기능을 제공하여 네트워크 주소에 따라 전송을 막았다가 풀었다가 할 수 있다. 또한 로드 분배를 통하여 데이터가 여러 경로를 타고 전송될 수 있도록 한다. 이 외에도 프로토콜이나 데이터의 크기, 중요도 등 여러 상황에 따라 트래픽의 전송 순서를 조정해주는 QoS(Quality of Service) 기능도 제공한다.

네트워크 기본이론 : 03 TCP/IP와의 만남

1. TCP/IP 개요

 - TCP/IP는 Transmission Control Protocol/Internet Protocol의 약자로 인터넷을 사용하기 위해 꼭 필요한 프로토콜이다.
 - 네트워크에 접속되는 호스트들은 고유의 주소를 가지고 있어서 자신이 속해 있는 네트워크 뿐만아니라 다른 네트워크에 연결되어 있는 호스트까지도 서로 데이터를 주고받을 수 있도록 만들어져 있는 것이 특징이다.

2. IP주소

 - 인터넷을 사용하는 PC 각각은 유일한 네트워크 주소(Logical)를 가지는데 이를 IP주소라고 한다.
 - 그러나 IP주소는 한정적이므로 다음과 같은 방식을 이용하여 IP주소를 공유한다.
  1) NAT : Network Address Translation의 약자로 내부 네트워크에서는 공인되지 않은 IP주소를 사용하고, 인터넷으로 나갈 때만 공인 주소(실제 IP주소)를 사용하는 방식
  2) PAT : 동일한 IP주소를 가지고 여러명이 인터넷에 접속하면서 포트번호만 바꾸는 방식
 - IP 주소는 210.126.12.99와 같은 형태를 띄며, 실제로는 이진수 8자리가 4묶음으로 이루어진 것으로, 중간에 점을 찍어서 표시하는 것이다.

3. 이진수의 사용

 - 컴퓨터에서 사용하는 모든 숫자는 이진수이므로 위에서 언급했던 것처럼 IP주소도 실제로는 이진수이다.
 - IP주소(IPv4)가 한정적이기 때문에 보다 더 많은 주소를 부여할 수 있는 방법인 IPv6가 대두되었다.(IPv4 : 2 ^ 32개 -> IPv6 : 2 ^ 128개)

4. TCP/IP의 특징

 - TCP/IP는 다음과 같은 특징을 가진다.

  1) IP 주소가 서로 같으면 안된다.
  2) 네트워크별로 동일한 네트워크 부분을 가져야 한다.
  3) 서브넷 마스크를 동일하게 가져야 한다.

 - 위와 같은 특징으로 인하여 네트워크 관리자의 IP주소 관리에 대한 부담이 컸었지만 IP주소를 자동으로 배정해주는 DHCP(Dynamic Host Configuration Protocol)의 등장으로 인해 사용자 IP주소 관리가 편해졌다.
 - DHCP 서버가 네트워크 상의 모든 IP주소를 가지고 있다가 클라이언트 PC가 켜지면서 네트워크에 브로드캐스트를 통하여 IP주소를 요청한다. DHCP 서버는 이 요청을 듣고 클라이언트에게 자신이 관리하는 IP주소 중 하나를 자동으로 주는 것이다.

네트워크 기본이론 : 02 네트워크와 케이블

1. LAN과 WAN

 - LAN(Local Area Network) : 한정된 지역 안에서의 네트워크 구축
 - WAN(Wide Area Network) : 서로 멀리 떨어진 곳을 네트워크로 연결

2. Ethernet

 - 네트워크를 구축하는 방법에는 Ethernet, Token-Ring, FDDI, ATM 방식 등이 존재하며, 어떤 네트워킹 방식을 사용하느냐에 따라 네트워크 장비들의 선택이 달라진다.
 - Ethernet은 위에서 본 것처럼 네트워킹의 한 방식으로 CSMA/CD라는 프로토콜을 사용하여 통신을 한다.
 - CSMA/CD(Carrier Sense Multiple Access/Collision Detection) : 통신하고자 하는 컴퓨터가 네트워크를 살펴봐서 아무도 통신을 하고 있지 않으면 무조건 자기 데이터를 실어서 보낸 다음 잘 갔는지 확인해보는 방식이다. 그러나 만약 동시에 두 개의 컴퓨터에서 데이터를 실어 보내려고 하면 충돌이 발생하게 되는데, 이를 Collision이라 한다. 이렇게 Collision이 발생하면 이 두 컴퓨터는 자신이 보내려던 데이터를 랜덤한 시간 동안 기다렸다가 다시 보내게 된다.

3. Token-Ring

 - 토큰을 가진 컴퓨터만이 네트워크에 데이터를 실어 보낼 수 있으며, 데이터를 다 보내고 나면 바로 옆 컴퓨터에게 토큰을 건네주는 방식이다.
 - 내가 지금 바로 보내야 할 데이터가 있고, 다른 컴퓨터들은 보낼 데이터가 하나도 없다고 하더라도 차례가 올 때까지 계속 기다려야하는 단점이 있다.

4. UTP 케이블

 - 네트워크 장비 사이의 연결에 사용되는 케이블에는 광 케이블, UTP 케이블, 동축 케이블 등 다양한 종류가 있으며, UTP는 Unshieled Twisted-pair의 약자로 우리 주변에서 가장 많이 사용되는 케이블이다.
 - 카테고리
  1) 카테고리 1 : 전화망에 사용
  2) 카테고리 2 : 최대 4Mbps의 속도로 데이터 전송
  3) 카테고리 3 : 10 Base T 네트워크에 사용되는 케이블로 최대 10Mbps의 속도로 데이터 전송
  4) 카테고리 4 : 토큰링 네트워크에서 사용되는 케이블로 최대 16Mbps의 속도로 데이터 전송
  5) 카테고리 5 : 기가비트 표준의 케이블

5. 케이블의 종류

 - ex) 10 Base T
  1) 10 : 지원 속도로 여기에서는 10Mbps를 지원하는 케이블임을 의미
  2) Base : Baseband용 케이블을 의미하며 Baseband는 디지털 방식, Broadband는 아날로그 방식
  3) T (or Number) : 알파벳은 케이블의 종류(?)로 여기에서는 TP케이블임을 의미하며 숫자가 나올 경우 최대 전송거리를 의미

6. 맥 어드레스

 - 맥 어드레스의 맥(MAC)은 Media Access Control의 약자로 모든 네트워크 장비들은 이 MAC주소를 이용하여 통신을 한다.
 - 인터넷은 TCP/IP 통신을 하고 따라서 통신을 하기 위해서 IP주소를 사용한다고 많이들 알고 있는데 사실 IP주소를 MAC주소로 바꾸는 절차인 ARP(Address Resilution Protocol)과정을 거친후 MAC주소를 이용하여 통신을 하고 있는 것이다.

 - ARP절차


 - 모든 네트워크 장비(Ethernet)들은 48bit의 고유 주소를 갖는데 이를 MAC주소라 하며, 00:60:97:8F:4F:86 과 같은 형태로 나타내어진다. 앞의 6자리는 생산자를 나타내느 코드로 OUI라 하며, 나머지 6자리는 각 생산자들이 장비에 분배하는 Host Identifier(시리얼 넘버)

7. 유니캐스트, 브로드캐스트, 멀티캐스트

 - 유니캐스트 : 현재 네트워크 상에서 가장 많이 사용되는 통신 방식으로 특정 목적지의 주소 하나만을 가지고 통신하는 방식이다. 어떤 PC가 유니캐스트 프레임을 뿌리게 되면 로컬 이더넷의 기본 성격이 붙어있는 모든 PC들에게 정보를 뿌리는 Shared방식이기 때문에 그 로컬 네트워크 상에 있는 모든 PC들은 일단  이 프레임을 받아들여서 랜카드에서 자신의 맥 어드레스와 비교하게 된다. 그 다음 자신의 랜카드 맥 어드레스와 목적지 맥 어드레스가 서로 다른 경우는 바로 그 프레임을 버리고, 같은 경우는 이 프레임을 CPU로 전달한다.
 - 브로드캐스트 : 로컬 랜 상에 붙어있는 모든 네트워크 장비들에게 보내는 통신이다. 브로드캐스트의 대표적은 예는 ARP이며, 외에도 라우터끼리 정보를 교환한다거나 다른 라우터를 찾을 때, 또 서버들이 자신이 어떤 서비스를 제공한다는 것을 모든 클라이언트들에게 알리 때 등 여러 경우에 사용된다. 그러나 브로드캐스트 프레임을 전송받은 PC의 랜카드는 목적지 주소에 상관없이 CPU로 정보를 전달해야 하며, 브로드 캐스트를 주기적으로 발생하는 성격때문에 전체 네트워크 뿐 아니라 PC자체의 성능 역시 떨어뜨리는 결과를 가져오기도 한다.
 * 참고사항 : 라우터는 원래 브로드캐스트를 막는 성질이 있다.
 - 멀티캐스트 : 보내고자 하는 그룹 멤버들에게만 한 번에 보내는 방식이다.(ex. 200 명의 사용자가 있는 네트워크에서 150 명에게만 같은 정보를 동시에 제공) 그러나 멀티캐스트는 라우터나 스위치에서 이 기능을 지원해 주어야만 사용가능하다. 추가적으로 멀티캐스트는 그룹에 포함되고 또 그룹에서 빠져나가는 것을 정의하기 위해 몇 가지 기술들을 사용하며, IP 주소의 경우에는 클래스 D를 사용한다.

8. OSI 7 Layer

 - International Organization for Standardization에서 만들었으며 통신이 일어나는 과정을 7단계로 나눈 것며, 통신을 7단계로 표준화하여 그 효율성을 높이기 위함이다. 7단계로 나눈 이유는 다음과 같다. 첫 번째, 데이터의 흐름이 한눈에 보인다. 두 번째, 문제 해결에 용이하다. 세 번째, 여러 회사 장비들을 사용해도 네트워크가 이상없이 돌아간다.
 - OSI 7 Layer
  (User)
  1) Application Layer<Specific Address>
  2) Presentation Layer<Specific Address>
  3) Session Layer<Specific Address>
  4) Transport Layer<Port Address>
  5) Network Layer<Logical Address> : 패킷 라우팅(라우터)
  6) Data Link Layer<Physical Address> : 프레임 오류 및 흐름 관리(브리지, 스위치)
  7) Physical Layer<Physical Address> : 비트 데이터 전달(통신 케이블, 리피터, 허브)

9. 프로토콜

 - 프로토콜이란 컴퓨터끼리 서로 통신하기 위해서 꼭 필요한 서로간의 통신 규약 또는 통신 방식에 대한 약속이다.
 - Protocol = Semantic + Syntax + Action

2013년 4월 9일 화요일

리눅스 시스템 프로그래밍 : 04 유저 환경(1)


1. 리눅스 계정 시스템

 리눅스는 다중 사용자 운영체제다. 이는 동시에 여러사람이 컴퓨터의 자원을 사용할 수 있음을 의미한다. 그러므로 리눅스 운영체제는 여러사람을 관리할 수 있는 시스템을 가지고 있어야 한다. 이것을 계정 시스템이라고 한다. 계정이란 컴퓨터 자원에 접근할 수 있는 사람들에 대한 정보로 이해하면 될 것이다.

 아니다. 엄밀히 따지자면, 사람이라는 표현은 잘못된것 같다. 운영체제의 계정에는 시스템 계정과 일반 사용자 계정 크게 두가지로 분류할 수 있는데, 사람이라하면 일반 사용자 계정만을 가리키는 것이기 때문이다. 그러므로 사람 대신 객체라고 표현하는게 옳은 것 같다. 다시 정리하자. 계정이란 컴퓨터 자원에 접근할 수 있는 객체에 대한 정보를 의미한다.


2. 계정 정보


 계정이라는 것은 컴퓨터 자원에 접근하기 위한 객체라는 것을 알게 되었다. 그렇다면, 이들 객체는 각 객체의 특징을 나타내주는 정보를 가지고 있을 것이다. 이것을 계정정보라고 하다. 계정정보는 다음과 같은 정보들을 포함하고 있을 것이다. 계정은 유저라고 부르기도 하며, 계정정보는 유저정보와 동일한 의미로 사용된다.

  • 계정이름 계정을 다른 계정과 분리시켜주는 이름
  • 권한 컴퓨터 자원은 그 한계가 있다. 무한대가 아니다. 또한 다중 사용자 운영체제인 리눅스에 의해서 접근하게 될경우, 시스템 보안과 데이터 보안의 차원에서 접근제어를 해야할 필요가 있다. 리눅스(:12)는 권한을 통해서 이를 관리한다. 즉 이 파일은 누구누구는 읽기만 가능하고, 어떤 그룹에 대해서는 읽기/쓰기가 모두 가능하다 라는 식으로 관리한다.
  • 패스워드 이름과 이름에 따른 권한이 주어졌다면, 이 권한을 요청한 유저가 정말로 합법적인 유저인지를 확인하는 과정을 거쳐야 할 것이다. 인증과정인 셈이다. 가장 널리 사용되는 방법은 아이디/패스워드를 통한 인증방법이다.

 위의 3가지 정보를 가지고 있으면, 완전한 하나의 계정을 만들어 낼 수 있다. 몇몇 부가적인 정보들이 더 필요한 경우가 있는데, 나머지는 말 그대로 부가정보들일 뿐이다.


3. 슈퍼유저


 컴퓨터 시스템은 회사와 매우 비슷한 면이 있다. 회사처럼 자원과 계정(사람)이 있으며, 권한이 부여된다. 입출입시 인증을 요구하기도 한다.

 회사에 CEO가 있다면, 운영체제(:12)에는 슈퍼유저(:12)가 있다. 슈퍼유저는 무엇이든지 할 수 있는 막강한 권한을 가진 특별한 유저를 칭한다. 회사의 경우 CEO라고 하더라도, 권한을 행사함에 있어서 여러가지 제약이 있는 반면, 슈퍼유저는 말그대로 슈퍼맨의 능력을 가지고 모든 능력을 행사할 수 있다. 다음과 같은 명령하나로 운영체제를 싹 날려버릴 수도 있다.

# rm -rf /

 전통적으로 유닉스에서 슈퍼유저는 root라는 계정이름이 부여된다. 리눅스 역시 유닉스의 이러한 전통을 따르고 있다. 슈퍼유저는 파일을 만들고 삭제하고, 파티션을 나누고, 유저를 추가하고 권한을 조정하는 등의 모든 업무를 처리할 수 있는 권한을 가지게 된다. 그 권한이 워낙 막강한 관계로, 최근의 몇몇 운영체제들은 root 라도 그 권한을 제한시키는 경우가 있다.


4. 유저 생성 과정


 아마도 여러분은 adduser(1) 명령을 이용해서 유저를 생성하는 법을 알고 있을 것이다. 여기에서는 실제 유저를 생성하기 위해서 어떤 과정을 거쳐야 하는지에 대해서 알아보도록 하겠다.


  4.1 유저 파일들


 리눅스에서 모든 정보는 파일을 통해서 관리된다는 것을 알고 있을 것이다. 유저정보 역시 마찬가지 이며, 유저와 관련된 파일들은 /etc 밑에 존재한다. 전통적으로 유닉스 시스템에서 /etc 디렉토리는 각종 설정파일을 저장하기 위한 목적으로 사용되어지고 있다. 유저 관련 주요 파일들은 다음과 같다.

passwd 유저 이름과 패스워드가 저장된다.
shadow passwd와 비슷하지만 보안이 강화되었다.
group 그룹 정보가 저장되어있다.
adduser.conf 유저생성과 관련된 변수들이 정의되어 있다.

각 파일들에 대한 내용은 아래에 다루도록 할 것이다.


  4.2 passwd 파일


 유저의 기본적인 정보는 /etc/passwd파일에 저장된다. 유저정보는 printable ASCII 문자로 입력이 되기 때문에 vi(:12)와 같은 에디터를 이용해서 내용을 확인할 수 있다. 다음은 passwd 파일 내용의 일부분이다.

# cat /etc/passwd
...
yundream:x:1000:1000:yundream,,,:/home/yundream:/bin/bash
mysql:x:110:121:MySQL Server,,,:/var/lib/mysql:/bin/false
mt-daapd:x:114:65534::/var/cache/mt-daapd:/bin/true
testyun:x:1004:1004:,,,:/home/testyun:/bin/bash
myyun:x:115:65534::/home/myyun:/bin/false
...
:를 구분자로 7개의 필드로 이루어진 간단한 구조를 하고 있다. 각 필드가 포함하는 내용은 다음과 같다.
유저:패스워드:UID:GID:GECOS:디렉토리:쉘
  1. 유저 : 시스템내에서 사용되는 유저 이름
  2. 패스워드 : 유저가 사용할 패스워드
  3. UID : 유저에게 부여되는 ID로 일련의 숫자다.
  4. GID : 유저가 포함되는 그룹의 ID로 일련의 숫자다.
  5. GECOS : 유저의 부가정보로 생략가능하다.
  6. 디렉토리 : 유저의 홈 디렉토리
  7. 쉘 : 유저가 사용하게 될 shell(:12) 프로그램

 기본적으로 /etc/passwd 를 편집할 수 있다면, 어렵지 않게 유저를 추가시키는 프로그램을 생성할 수 있다. 마찬가지로 /etc/passwd 파일을 읽어들이는 것으로, 사용자의 정보를 얻어올 수도 있다. 파일의 권한설정등에 사용되는 값은 유저 이름이 아닌 UID이기 때문에, /etc/passwd 파일은 자주 분석될 필요가 있다. 이러한 분석 프로그램은 프로그래머가 직접 작성할 수도 있지만 몇몇 함수를 이용하면 쉽게 유저정보를 얻어올 수 있다. 이에 대해서는 마지막에 사용자 정보를 얻어오는 프로그램을 작성하는 것으로 알아보도록 할 것이다.

그런데, 이상한 점이 있다. 패스워드 영역이 x로 되어있다. 패스워드가 몽땅 x일리는 없을테고 !!?


  4.3 shadow password


 passwd 파일에 사용자 패스워드가 없다면, 어떻게 유저이름과 패스워드로 인증이 가능할 건지가 문제가 된다. 우선 passwd 파일의 문제점에 대해서 알아보도록 하자. 다음은 passwd 파일의 권한이다.

# ls -al /etc/passwd
-rw-r--r-- 1 root root 1522 2008-01-09 23:34 /etc/passwd

 누구든지 읽을 수 있게 되어있다. 단방향 암호화 되어 있기는 하지만, 암호화된 일련의 문자를 얻을 수 있다면, 패스워드 검사 프로그램을 만들어서 패스워드를 찾아낼 수 있다. 이는 보안상 심각한 문제라고 할 수 있다.

 그래서 shadow password라는 방식을 도입했다. /etc/passwd 에는 패스워드를 제외한 정보만을 저장하고, 실제 패스워드는 오직 root 계정만 읽을 수 있는 /etc/shadow파일에 저장하는 것으로 passwd 파일의 보안문제점을 해결한 방식이다. /etc/shadow 파일의 권한을 확인해 보면, 단지 root 계정만 읽을 수 있음을 알 수 있다. 일반 유저가 읽을 수 없기 때문에, 패스워드 보안을 달성하게 된다.

#ls -al /etc/shadow
-rw-r----- 1 root shadow 996 2008-01-09 23:34 /etc/shadow

 사실 사용자가 컴퓨터 시스템에 로그인 할것인지 안할 것인지를 결정하는 권한은 root 사용자만 가지고 있기 때문에, 다른 유저가 읽을 필요는 없을 것이다.

 단 일반 사용자도 패스워드를 제외한 다른 유저의 정보를 알아야할 필요가 있기 때문에, /etc/passwd 파일을 남겨두게 된다. 유저정보는 /etc/passwd 패스워드 정보는 /etc/shadow 를 통해서 유지된다. 다음은 shadow 파일에 저장된 정보들이다.

yundream:$1$1S6/q4Ed$7en1qZdeOVofyEjqaofy/:13663:0:99999:7:::

 역시 :를 구분자로 해서 필드를 구분하고 있다. 각 필드의 정보는 getspend(3) 메뉴얼 문서를 참고하기 바란다.

패스워드는 crypt(3)와 md5(:12)를 이용해서 단방향으로 암호화 된다.


5. 사용자 정보 얻어오기


 그럼 실제 사용자 정보를 얻어오는 방법에 대해서 알아보도록 하자. 우선 사용자 정보는 /etc/passwd 파일의 내용을 읽어와서 구분자 :로 필드를 쪼개고, 이것들을 구조체에 집어 넣는 방법을 생각해볼 수 있을 것이다.

 그러나 위의 방법은 너무 귀찮다. 다행히도 리눅스는 /etc/passwd 파일에서 사용자 정보를 얻어오기 위한 표준 라이브러리(:12) 함수인 getpwent함수를 제공하고 있다.

#include <pwd.h>
#include <sys/types.h>

struct passwd *getpwent(void);

 getpwent 함수는 /etc/passwd 에서 패스워드 정보를 읽어들여서 passwd 구조체에 저장하고, 이것에 대한 포인터를 되돌려준다. passwd 구조체는 다음과 같이 정의되어 있다.


struct passwd
{
    char  *pw_name;     /* 유저 이름 */
    char  *pw_passwd;   /* 유저 패스워드 */
    uid_t pw_uid;       /* 유저 ID (UID) */ 
    gid_t pw_gid;       /* 그룹 ID (GID) */ 
    char  *pw_gecos;    /* 실제 이름 */
    char  *pw_dir;      /* 홈 디렉토리 */
    char  *pw_shell;    /* 사용자 쉘 */
};

다음은 getpwent()함수를 이용해서 유저정보를 읽어오는 간단한 프로그램이다.

#include <pwd.h>
#include <string.h>
#include <stdio.h>
#include <sys/types.h>

int main(int argc, char **argv)
{
    char *name;
    if (argc != 2)
    {
        printf("Usage : %s username\n", argv[0]);
        return 1;
    }
    name = argv[1];

    struct passwd *pass_info = NULL;

    while((pass_info = getpwent()) != NULL)
    {
        if (strncmp(name, pass_info->pw_name, strlen(name)) == 0)
        {
            printf("%12s uid(%d) gid(%d) home(%s)\n",
                pass_info->pw_name,
                pass_info->pw_uid,
                pass_info->pw_gid,
                pass_info->pw_dir);
            return 0;
        }
    }
    printf ("Can not find User : %s\n", name);
    return 1;
}

네트워크 기본이론 : 01 네트워크 세상에 들어서며

1. 네트워크

 - 네트워킹이란? 여러 장비 사이에서 정보의 공유를 위해 서로 연결하는 것.

2. 인터넷

 - 인터넷에서 인터는 연결을 의미하는 것으로 인터넷이란 네트워크를 연결한 것.
 - 인터넷은 하나의 프로토콜(TCP/IP)을 사용하고, 웹 브라우저를 통해 인터넷을 탐험하며, 인터넷에는 수 많은 정보가 있다는 특징을 지닌다. 여기에서 프로토콜이란 간단히 말해서 대화의 규칙이라고 생각하면 된다.

3. 인트라넷

 - 회사에서 쓰는 여러가지 프로그램들을 마치 인터넷을 사용하는 것처럼 쓰도록 만들어 놓은 것으로, 회사의 직원 이외에는 사용할 수 없는 특징을 지닌다.

4. 엑스트라넷

 - 인트라넷을 협력 회사나 고객에게 사용할 수 있도록 확대한 것이다.

2012년 12월 11일 화요일

리눅스 시스템 프로그래밍 : 03 입력과 출력(4)


9. 파일의 권한과 모드

 리눅스는 다중 사용자 운영체제이며, 때문에 모든 파일에는 권한이 부여된다. 리눅스 상에서는 모든 것이 파일로 표현되기 때문에, 파일에 권한을 부여한다는 얘기는 운영체제와 컴퓨터의 모든 것에 대한 권한이 부여될 수 있다는 것과 마찬가지가 된다.

 예컨데 권한이라 함은 '이 파일은 내 것이며 나만 읽을 수 있다' 라든지 '스터디 그룹에 포함된 사람들은 읽을 수 있지만, 다른 사람들은 읽을 수 없다' 등과 같은 접근 권한을 말한다. 여기에 접근 권한 외에도 읽기와 쓰기 가능에 대한 권한(접근 범위 - 모드)까지 세부적으로 분류할 수 있다. 현실에서와 마찬가지다. 현실에서도 직위나 직책, 부서에 따라서 문서에 대한 접근 권한이 정해져 있으며, 읽기와 쓰기에 대한 행위도 정의된다. 리눅스 운영체제의 파일은 읽기와 쓰기 외에도 실행에 대한 모드를 가지고 있다는게 현실세계에서의 문서시스템과 다른점이라 할 수 있을 것이다.

 파일에 대한 권한은 소유자, 그룹, other 세 부분으로 나뉜다. 소유자는 개인이라고 생각할 수 있다. 파일에 대한 모드는 위에서 언급했듯이 읽기, 쓰기, 실행 3개로 세분화 될 수 있다. 이들의 조합으로 파일의 권한과 모드가 정의된다.

 우리는 ls 를 통해서 파일의 권한과 모드를 확인할 수 있다.

# ls -al
-rw-r--r--  1 yundream yundream 4806656 2006-07-28 14:00 My_sweet_darlin.mp3
drwxr-xr-x  5 yundream yundream    4096 2007-07-29 01:26 PicasaDocuments
-rwxr-xr-x  1 yundream yundream    7402 2007-11-26 00:01 UserInfoRead
-rw-r--r--  1 yundream yundream     751 2007-11-26 00:02 UserInfoRead.c
-rwxr-xr-x  1 yundream yundream    7433 2007-11-25 23:33 UserInfoWrite
-rw-r--r--  1 yundream yundream    1087 2007-11-25 23:56 UserInfoWrite.c
drwxr-xr-x  2 yundream yundream    4096 2007-07-31 23:51 backup

10. 파일의 종류와 권한, 모드 알아내기

 모든 것이 파일로 표현될 수 있다는 점과 다중 사용자 운영체제라는 리눅스 운영체제의 특성상 파일의 종류와 권한,모드를 알아내는 것은 매우 중요하다. 파일을 다루는 프로그램을 작성할 경우 가장 먼저 하는 일이 접근 가능한 파일 인지를 확인하는 일이다. 리눅스는 파일에 대한 정보를 얻어올 수 있는 stat 라는 함수를 제공한다.

 #include <sys/stat.h>

 int stat(const char *file_name, struct stat *buf);

 파일 이름 file_name 를 인자로 주면, 그에 대한 정보를 stat 구조체에 담아서 되돌려준다. stat 에는 다음과 같은 파일 정보들이 담겨져 있다.
 
struct stat {
    dev_t         st_dev;      /* device */
    ino_t         st_ino;      /* inode */
    mode_t        st_mode;     /* protection */
    nlink_t       st_nlink;    /* number of hard links */
    uid_t         st_uid;      /* user ID of owner */
    gid_t         st_gid;      /* group ID of owner */
    dev_t         st_rdev;     /* device type (if inode device) */
    off_t         st_size;     /* total size, in bytes */
    blksize_t     st_blksize;  /* blocksize for filesystem I/O */
    blkcnt_t      st_blocks;   /* number of blocks allocated */
    time_t        st_atime;    /* time of last access */
    time_t        st_mtime;    /* time of last modification */
    time_t        st_ctime;    /* time of last change */
};
 
 주석을 보는 정도로 각 멤버 변수가 의미하는 바를 쉽게 이해할 수 있을 것이다. 그러니 몇 가지 생소한 멤버 변수들만 설명하도록 하겠다.
  • st_ino : 파일의 일련번호다. 이 번호는 하나의 장치에서 유일하게 존재하며, 파일과 파일을 구분하게 해준다. 하나의 장치에서만 유일하다는 것에 주의하기 바란다.
  • st_dev : 파일이 속한 장치의 식별번호다. st_ino 와 st_dev 의 쌍은 전체 시스템에서 유일하다.
  • st_nlink : 파일의 hard link(이하 하드링크)의 갯수를 알려준다. 하드링크에 대한 내용은 따로 자세히 다루도록 하겠다.
  • st_mode : 파일의 형식을 알려준다. 이 값을 이용해서, 파일이 디렉토리인지, 링크인지, 장치 파일인지 등을 알아낼 수 있다. 이 값을 분석하기 위한 다음과 같은 메크로를 제공한다. 각 메크로는 검사하고자 하는 내용이 참이면 0이 아닌 값을 리턴한다.
    1. S_ISDIR(st_mode) : 파일이 디렉토리인지 검사한다.
    2. S_ISCHR(st_mode) : 파일이 문자 장치 파일인지 검사한다.
    3. S_ISREG(st_mode) : 일반파일인지 검사한다.
    4. S_ISFIFO(st_mode) : FIFO 혹은 pipe 파일인지 검사한다.
    5. S_ISLNK(st_mode) : symbolic 링크 인지 검사한다.
    6. S_ISSOCK(st_mode) : 소켓 파일인지 검사한다.
 st_mtime, st_atime, st_ctime 에서 되돌려주는 시간은 Unix 시간으로 1970년 1월 1일 00:00:00 부터 현재까지 흐른 시간을 초로 환산한 값이다. 이 초로 된 시간을 인간이 읽기 쉬운 형태로 만들어주는 시간관련 함수가 있는데, 이들 내용은 따로 다루도록 할 것이다.

 다음은 파일의 각종 정보를 읽어오는 프로그램이다. 프로그램의 이름은 stat.c 로 하겠다.

#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <unistd.h>
#include <stdio.h>
#include <pwd.h>
#include <grp.h>

int main(int argc, char **argv)
{
    int return_stat;
    char *file_name;
    struct stat file_info;

    mode_t file_mode;

    if (argc != 2)
    {
        printf("Usage : ./file_info [file name]\n");
        exit(0);
    } 
 
    file_name = argv[1];

    if ((return_stat = stat(file_name, &file_info)) == -1)
    {
        perror("Error : ");
        exit(0);
    }

    file_mode = file_info.st_mode;
 
    printf("파일이름 : %s\n", file_name);
    printf("=======================================\n");
    printf("파일 타입 : ");
    if (S_ISREG(file_mode))
    {
        printf("정규파일\n");
    }
    else if (S_ISLNK(file_mode))
    {
        printf("심볼릭 링크\n");
    }
    else if (S_ISDIR(file_mode))
    {
        printf("디렉토리\n");
    }
    else if (S_ISCHR(file_mode))
    {
        printf("문자 디바이스\n");
    }
    else if (S_ISBLK(file_mode))
    {
        printf("블럭 디바이스\n");
    }
    else if (S_ISFIFO(file_mode))
    {
        printf("FIFO\n");
    }
    else if (S_ISSOCK(file_mode))
    {
        printf("소켓\n");
    }

    printf("OWNER : %d\n", file_info.st_uid);
    printf("GROUP : %d\n", file_info.st_gid);
    printf("dev   : %d\n", file_info.st_dev);
    printf("inode : %d\n", file_info.st_ino);
    printf("FILE SIZE IS : %d\n", file_info.st_size);
    printf("마지막 읽은 시간 : %d\n", file_info.st_atime);
    printf("마지막 수정 시간 : %d\n", file_info.st_mtime);
    printf("하드링크 된 파일수 : %d\n", file_info.st_nlink);
}

테스트 삼아서 stat.c 에 대한 조사를 해보자.

$ ./stat stat.c
파일이름 : stat.c
=======================================
파일 타입 : 정규파일
OWNER : 1000
GROUP : 1000
dev   : 2051
inode : 6603353
FILE SIZE IS : 1692
마지막 읽은 시간 : 1196074251
마지막 수정 시간 : 1196074249
하드링크 된 파일수 : 2

  10.1 hard link와 symbolic link

 바로 위에서 link(이하 링크)가 몇 번 언급 되었었다. 이 링크에 대해서 자세히 알아보도록 하겠다. 링크는 파일을 가리키는 일종의 별칭으로 주로 관리의 목적으로 사용한다. 예를 들어 오픈 오피스의 문서 프로그램을 실행시키기 위해서 /usr/local/openoffice/bin/openoffice_swrite 를 실행시켜야 한다고 가정해보자. 이 것을 기억해서 실행하는 일은 보통 곤욕스러운 일이 아닐 것이다. 이 경우 링크를 이용해서 간단하게 문제를 해결할 수 있다.

# ln -s /usr/local/openoffice/bin/openoffice_swrite /usr/bin/swrite 
 
/usr/bin 은 환경 변수 PATH 에 등록이 되어있을 것이기 때문에, 간단하게 swrite 만 입력하는 정도로 /usr/local/openoffice/bin/openoffice_swrite 를 실행할 수 있게 된다. 이제 ls를 이용해서 /usr/bin/swrite 의 정보를 확인해 보도록 하자.

$ ls -al swrite
lrwxrwxrwx 1 root root 43 2007-11-26 23:44 swrite -> /usr/local/openoffice/bin/openoffice_swrite

 swrite 가 원본 openoffice_swrite 를 링크하고 있는 것을 확인할 수 있을 것이다. 직관적으로 이해할 수 있을 것이다. 추가적으로 link 는 심볼릭 링크와 하드 링크로 나뉘는데 바로 다음에서 이 둘의 차이점에 대해서 알아보도록 하겠다.


  10.2 hard link


 앞서 파일은 장치 내에서 식별되기 위해서 inode(하나의 장치에서만 유일한 파일의 일련번호) 를 가진다는 것을 언급했었다. 여기에 inode 가 1234 인 파일 myfile 이 있다고 가정해보자. 이것을 다른 Directory 에 복사하기 위한 가장 일반적인 방법은 파일을 copy 하는 것으로 이 경우 새로운 inode 를 가지는 파일이 생길 것이다. 그럼 cp 를 이용해서 파일을 복사해보도록 하자.

# mkdir testdir
# cp myfile testdir/myfile2

 이제 두 개 파일의 inode 를 확인해보자. stat 함수를 이용해서 프로그램을 만들 필요는 없다. ls 의 -i 옵션을 사용하면 간단하게 파일의 inode 값을 알아낼 수 있다.

# ls -i myfile 
1131883 myfile 
# ls -i testdir/myfile2
1163816 testdir/myfile2

 내용은 동일하지만 완전히 다른 파일이 생성되었음을 알 수 있다.

 이 방법은 대부분의 경우 유용하게 사용할 수 있겠지만 하나의 파일을 여러 개의 디렉토리에 공유할 목적으로 사용하고자 할 경우 문제가 발생한다. 예를 들어 주소록 파일인 /home/yundream/mydata.txt 가 있다고 가정해보자. 이 파일을 /home/dragona 에 공유하길 원한다. 만약 mydata.txt 에 새로운 내용이 추가되거나 삭제되면 /home/dragona 에도 그대로 적용되어야 한다. 단순히 copy 할 경우에는 한쪽에서 변경하면, 다른 한쪽에는 반영되지 않을 것이다. 링크를 사용하면 이 문제를 간단하게 해결할 수 있다.

# ln mydata.txt /home/dragona


 이제 한쪽에서 파일을 수정해보자. 다른 쪽도 그대로 수정된 내용이 반영되어 있음을 확인할 수 있을 것이다. ls -i 로 확인해보면 두 개의 파일이 동일한 inode 를 가지고 있음을 확인할 수 있을 것이다. 이것을 링크라고 하며, 위에서와 같이 inode 를 공유해서 사용하는 것을 하드 링크 라고 한다. 이해하기 쉽게 그림으로 나타내보면 다음과 같다.


 이러한 하드 링크로 얻을 수 있는 장점은 데이터를 공유할 수 있다는 것 외에, 디스크를 아낄 수 있다는 장점도 가진다. 데이터를 직접 복사하는 것이 아니기 때문이다. 원본은 하나이고 inode 만 공유할 뿐이다. 하드 링크를 하나 생성하면 inode 공유 카운터가 1증가할 뿐이다. ls -al 로 mydata.txt 원본 파일의 정보를 확인해 보자

# ls -al mydata.txt
-rw-r----- 2 yundream yundream 192 2007-11-26 23:57 mydata.txt

 하드 링크 카운터가 하나 증가해서 2가 되어 있는 것을 확인할 수 있을 것이다. 파일을 하나 지우고 나서 ls 결과를 보면 카운터가 하나 줄어서 1이 되는 것을 확인할 수 있을 것이다.

 하드 링크를 사용할 때 주의해야 할 점이 있다. 하드 링크는 inode 를 가리킨다. 이 때, inode 는 하나의 장치에서만 유일하므로 다른 장치로의 하드링크는 불가능 하다는 점이다. 왜냐하면 다른 장치에서 유일하다는 것을 보장할 수 없기 때문이다. 이런 경우에는 심볼릭 링크를 사용해야 할 것이다.


11. 심볼릭 링크


 하드 링크와 달리 심볼릭 링크는 별도의 inode 를 가지는 파일로 원본 파일에 대한 inode 와 함께 장치 정보까지 가지고 있다.(원본 파일의 포인터) 어떤 파일에 대한 inode 와 장치 정보를 알고 있다면, 전 시스템에서 유일한 파일을 가리킬 수 있기 때문에 장치에 관계없이 링크를 걸 수 있게 된다.

 그럼 mydata.txt 를 원본 파일로 하는 심볼릭 링크 mydata2.txt 를 만들어 보도록 하자. ln 명령에 -s 옵션을 주면 심볼릭 링크를 생성할 수 있다.

# ln -s mydata.txt mydataln.txt

 이제 -i 옵션을 이용해서 두 개 파일의 inode 를 비교해 보면 서로 다른 별개의 inode 를 유지하고 있음을 알 수 있을 것이다. ls -l 을 이용해서 심볼릭 링크가 가리키는 원본 파일의 이름을 얻어올 수 있다.

# ls -l mydataln.txt 
lrwxrwxrwx 1 yundream yundream 10 2007-11-28 01:49 mydataln.txt -> mydata.txt


12. 표준입력, 표준출력, 표준에러


 프로그램은 어떤 값을 입력 받아서 처리하고 그 결과를 출력하는 일을 한다. 입력은 보통 키보드를 통해서 이루어지고 출력은 모니터를 통해서 이루어진다. 대부분의 프로그램이 이러한 입/출력 방식을 사용한다. 따라서 프로그램이 실행될 때에는 기본적으로 키보드 장치와 모니터 장치를 열어서 입/출력이 가능하게 해놓았다. 이렇게 키보드 장치를 통한 입력을 표준입력이라하고, 모니터를 통해 출력하는 것을 표준출력이라고 한다.

 키보드를 통한 입력을 표준입력이라고 정의 하는 것은 문제가 없다. 그러나 모니터를 통한 표준출력에는 약간의 문제가 있다. 프로그램이 모니터에 출력하는 정보에는 입력 데이터를 정상적으로 처리해서 나오는 결과값 외에 잘못 처리되어서 출력되는 결과값이 있기 때문이다. 덧셈 프로그램을 만들었는데, 피연산자에 숫자 대신 알파벳 문자 등을 넣었다면, 프로그램은 에러 메시지를 출력할 것이다. 그런데 똑같이 모니터에 출력이 되어버리면, 결과값이 에러인지 아닌지 구분할 수 없을 것이다.

 이렇게 출력값이 정상인지 에러인지를 구분하기 위해서 표준출력 외에 표준에러를 제공한다. 결과적으로 프로그램은 최초 실행시 다음과 같은 3개의 입/출력 장치를 open 하게 된다.

  • 표준입력 : 키보드를 통한 입력
  • 표준출력 : 모니터로 출력되는 정상 메시지
  • 표준에러 : 모니터로 출력되는 에러 메시지

 우리는 리눅스가 모든 것을 파일로 처리한다는 것을 배워서 알고 있다. 표준입력, 출력, 에러 역시 파일로 처리된다. 더불어 리눅스에서 파일을 다룰때에는 파일 이름이 아닌, 파일 지정 번호를 이용한다는 것도 알고 있다. 리눅스는 이들 3개의 파일에 대해서는 파일 지정 번호를 고정시켜 놓았다.


  • 표준입력 : 0
  • 표준출력 : 1
  • 표준에러 : 2

 다음은 표준입력, 표준출력, 표준에러를 이용해서 만든 간단한 나눗셈 프로그램이다. 표준입력을 통해서 2개의 수를 입력받아서 나눈 결과를 표준출력을 통해서 출력한다. 이 프로그램의 이름은 stdio.c 로 하겠다.

#include <unistd.h>
#include <sys/types.h>
#include <fcntl.h>
#include <stdio.h>
#include <string.h>

#define STDIN  0
#define STDOUT 1
#define STDERR 2

#define ERRMSG "Devide Not Zero\n"
int main()
{
  int a;
  int b;
  char buf[80];

  read(STDIN, buf, 80);
  a = atoi(buf);

  read(STDIN, buf, 80);
  b = atoi(buf);
  if (b == 0)
  {
    write(STDERR, ERRMSG, strlen(ERRMSG));
    return 1;
  }

  sprintf(buf, "%d / %d = %d\n", a, b, (int)(a/b));

  write(STDOUT, buf, strlen(buf));
  return 0;
}

  • 18 표준입력으로 분자를 입력받는다. 키보드로 부터 입력받는 값은 문자열로 atoi(3) 함수를 이용해서 int형 값으로 변경했다.
  • 21 표준입력으로 분모를 입력받는다.
  • 23 ~ 27 나눗셈에서는 분모가 0이 되는걸 허용하지 않고 있다. 그러나 실수로 0을 입력할 수 있으므로, 입력값을 검사해서 0이면 에러메시지를 출력하고 종료하도록 하고 있다. 이때 결과값은 에러메시지 이므로 표준에러를 통해서 출력했다.
  • 31 나눈 결과값을 표준출력을 이용해서 모니터에 출력한다.

 표준출력과 표준입력을 어떻게 사용하는지 이해하는 것은 어렵지 않을 것이다. 그러나 표준에러를 어떻게 사용해야 할지는 감이오지 않을 것이다. 걱정할 필요 없다. 아래의 재지향을 공부하다 보면, 자연스럽게 감이 오게 될 것이다.


13. 입출력 재지향


 입/출력 재지향 혹은 I/O Redirection 에 대해서 알아보자. 일단 재지향의 의미에 대해서 알고 넘어갈 필요가 있을 것 같다. 재지향의 사전적 의미는 '다른 방향으로 보낸다' 이다. 여기에 맞추어 입/출력 재지향을 사전적 의미 그대로 해석하자면, 입력과 출력을 다른 방향으로 보낸다는 의미가 될 것이다. 실제 입/출력 재지향은 사전적의미 그대로 이해하면 된다.

 리눅스에서 모든 것은 파일로 다루어진다고 했다. 이는 입력과 출력에도 예외없이 적용이 되므로, 입력과 출력을 다른 방향으로 보낸다는 것은 입력과 출력을 다른 파일로 보낸다는 것과 같은 의미이다. 예컨데, 키보드로부터 입력 받은 표준입력 데이터를 일반 파일로 보내거나 프린터(파일)로 보내는 등의 일이 가능하다는 얘기가 된다. 일반 파일을 프린터로 보내거나, 표준출력을 표준에러로 보내는 등의 일 역시 가능하다. 모든 것이 파일이기 때문에 모든 방향으로의 재지향이 가능하다.

 stdio.c 파일을 예로 들어서 설명해보도록 하겠다. stdio.c 프로그램은 입력을 검사해서 분모가 0 이 되면, 에러 메시지를 출력하도록 했다. 이 에러 메시지는 표준에러 형태로 모니터에 출력된다. 입력이 제대로 이루어져서 결과값이 나올 경우에는 표준출력 형태로 모니터에 출력이 된다. 이를 파일로 재지향 해보도록 하자.

 쉘에서는 꺽쇠를 이용해서 재지향을 이용할 수 있다. 표준출력을 result.txt 파일로 재지향하고 결과를 확인해 보도록 하자.

# ./stdio > result.txt
1234
2
# cat result.txt
1234 / 2 = 617

 프로그램을 만들어서 테스트 할 경우 디버깅 등의 목적으로 에러 메시지를 파일로 따로 저장해둬야 할 필요가 생긴다. 그렇다면 stdio 의 표준에러를 파일로 재지향 시키면 될 것이다.

# ./stdio 2> err.txt
1000
0
# cat err.txt
Devide Not Zero

 표준에러를 표준출력으로 재지향 시킬 수도 있다.


# ./stdio 2>1& 

 이제 표준에러도 표준출력 형태로 모니터에 뿌려지게 된다. 표준에러를 표준출력으로 재지향 시키는 예는 grep 등을 이용해서 결과를 모니터링 하는 스크립트를 만들기 위해서 자주 이용된다. 아래의 경우를 보도록 하자.


# ./stdio | grep Not  > err.log

 위의 스크립트는 stdio 의 실행결과 중 분모가 0인 경우를 err.log 로 남기기 위한 목적으로 작성되었다. 그렇지만 예상과는 다르게 분모가 0인 경우도 err.log 에 남겨지지 않을 것이다. 왜냐하면 파이프 | 는 표준출력 결과만을 grep 로 넘기는데 Device Not Zero는 표준에러이므로 파이프를 통해서 grep로 넘어가지 않기 때문이다.

이때 표준에러를 표준출력으로 재지향 시키는 방법으로 문제를 해결할 수 있다. 위의 스크립트를 아래와 같이 수정한다음에 테스트해보도록 하자.

# ./stdio 2>&1 | grep Not > err.log
1000
0
# cat err.log
Devide Not Zero

 표준출력결과가 파일로 저장된걸 확인할 수 있을 것이다.

 이론적으로는 파일에 저장된 내용을 각 장치에 재지향 시키는 것 만으로도 해당 장치를 이용할 수 있다. 예를 들자면 wav 파일을 읽어서 사운드 카드를 가리키는 장치 파일에 재지향 시켜서 wav 파일을 플레이 하는 것이다.

# cat sound.wav > /dev/audio

 재지향의 개념에 대해서 알아보았는데, 정작 중요한 것은 재지향이 시스템 프로그래밍의 관점에서 어떻게 구현이 되는가 하는 것이다. 간단히 생각해 보자면, 두 개의 파일을 연 다음에 하나의 파일의 내용을 읽어서 다른 파일로 복사하면 된다. 표준출력을 파일로 재지향한다면, 표준출력과 파일을 연 다음에 표준출력의 내용을 읽어서 파일에 그대로 쓰는 형식이다.

 그러나 이 방식은 매우 복잡하다. 이보다는 dup2 함수를 이용해서 좀 더 간단하게 재지향을 구현할 수 있다. 아래의 코드를 컴파일 한 다음 실행시켜 보도록 하자.

#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <stdio.h>
#include <string.h>

#define STDIN  0
#define STDOUT 1
#define STDERR 2

int main(int argc, char **argv)
{
  int fd;
  fd = open("test.log", O_CREAT|O_WRONLY, S_IRUSR|S_IWUSR|S_IRGRP|S_IWGRP);
  fd = dup2(fd, STDOUT);
  printf("Hello World %d\n", fd);
}

  • 15 : 재지향할 파일로 test.log 를 오픈했다. fd 는 아마도 3일 것이다.
  • 16 : dup2 함수를 이용해서 fd를 STDOUT 로 복사했다.
  • 17 : printf 함수를 이용해서 표준출력 했지만 STDOUT 는 test.log 의 파일 지정자로 복사가 되었기 때문에, 모니터로 출력이 되는 것이 아니고 파일로 출력이 된다.

 이 정도면 재지향의 구현 개념에 대해서 정리가 되었으리라 생각된다. dup 와 dup2 는 프로세스간 입/출력을 공유하기 위한 용도로 나중에 자세히 언급이 될 것이다. 우선은 이런 함수가 있다는 정도만 이해하고 넘어가도록 하자.


14. 입출력 버퍼 비우기


 일반적으로 버퍼는 성능을 높이기 위한 목적으로 사용한다. 예컨데, 1byte 씩 2048번 쓰는 것 보다는 , 1024byte씩 2번 쓰는게 훨씬 효율적일 것이다. 일반 응용 차원에서 뿐만 아니라, 운영체제 차원에서도 이러한 규칙은 동일하게 적용된다. 이에 따라 입력과 출력에 대해서도 별도의 버퍼를 유지하게 된다. 예를 들어 write 를 이용해서 화면에 데이터를 출력한다고 하면, 1byte 씩 쓸 때마다 출력되는 것이 아니고, 버퍼에 쌓아두고 있다가 버퍼가 가득 찼을 때 출력을 하게 된다.

#include <stdio.h>
#include <string.h>
#include <stdlib.h>

int main(int argc, char **argv)
{
  int i = 1;
  while(1)
  {
    printf("%d",i);
    usleep(100);
  }
}

 위 코드를 실행시켜 보기 바란다. 버퍼가 가득차기 전까지는 화면에 출력시키지 않는 것을 확인할 수 있을 것이다. 대개의 경우 버퍼의 크기는 1024이므로, 1024개의 문자가 기록되었을 때, 한번에 화면에 출력되는 것을 확인할 수 있을 것이다.

그러나 때때로, 곧바로 버퍼가 채워지기 전에 버퍼의 내용을 파일에 쓰고, 버퍼를 비울 필요가 있을 것이다. 만약 버퍼가 다 채워지지 않아서 파일에 쓰지 않은 상태에서 프로그램이 종료되어 버린다면, 버퍼에 있는 내용은 날아가 버릴 것이다. 위의 프로그램을 중간에 Ctrl+C 를 눌러서 종료시켜 보기 바란다. 버퍼의 내용이 버려짐을 확인할 수 있을 것이다. 이때 쓰는 함수가 fflush() 로, 이 함수를 호출하게 되면, 버퍼의 내용을 즉시 파일에 쓰게 된다.

 위 코드를 아래와 같이 수정해보자.

#include <stdio.h>
#include <string.h>
#include <stdlib.h>

int main(int argc, char **argv)
{
  int i = 1;
  while(1)
  {
    printf("%d",i);
    fflush(stdout);
    usleep(100);
  }
}

 이제 매번 버퍼에 있는 내용을 파일(여기에서는 모니터)에 쓰는 것을 확인할 수 있을 것이다.


15. 사용한 함수들 정리


  • open(2) : 파일을 연다.
  • write(2) : 파일을 쓴다.
  • read(2) : 파일의 내용을 읽는다.
  • close(2) : 열린 파일을 닫는다.
  • printf(3) : 문자열을 화면에 표준출력 한다.
  • dup2(2) : 파일지정번호를 복사한다.
  • perror(3) : 에러메시지를 표준에러로 출력한다.

2012년 12월 6일 목요일

리눅스 시스템 프로그래밍 : 03 입력과 출력(3)


8. 원시 데이터타입의 데이터와 구조체데이터 읽고 쓰기

 그럼 이전 포스트에서 다룬 data.txt 에 저장된 int형 정보를 읽어서 화면에 출력하는 프로그램을 작성해 보도록 하자. 프로그램의 흐름은 간단하다. data.txt 를 읽기 전용 으로 연 다음 read 함수를 이용해서 4byte 씩 읽어들인다. 읽어들인 데이터는 printf 함수를 이용해서 화면에 출력하면 된다.

#include <stdlib.h>
#include <stdio.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

#define MAXLEN 80
int main()
{
  int fd;
  int readn = 0;
  int buf;
  fd = open("data.txt", O_RDONLY);
  if (fd < 0)
  {
    perror("file open error:");
    return 1;
  }
  while( (readn = read(fd, (void *)&buf, sizeof(buf) )) > 0)
  {
    printf("Read Data : %d\n", buf);
  }
}

 읽을 정보가 int형 데이터 이므로, int형 데이터 타입의 
크기 만큼 - 대부분의 경우 4byte - 읽어서 buf 에 복사하고 있다. 읽어들인 정보는 21줄에서 printf 를 통해서 
출력했다.

 이 프로그램을 실행시키면 다음과 같은 결과를 보여줄 것이다.

# ./read
Read Data : 0
Read Data : 2
Read Data : 4
Read Data : 6
Read Data : 8
...

 문자열 데이터 이거나, int 형 숫자 데이터 이거나 컴퓨터의 입장에서는 비트의 나열일 뿐임을 명심할 필요가 있다. 단지 표현의 차이을 뿐이다. 똑같은 비트의 나열이라도 문자열로 표현하고자 하면 문자열이 되는 거고, 숫자로 표현하고자 하면 숫자로 표현된다.

  8.1 좀더 복잡한 구조체 데이터 읽고 쓰기

 컴퓨터의 관점에서 모든 데이터는 bit 의 나열일 뿐이라는 것을 이해한다면, 구조체를 읽고 쓰는 것 역시 전혀 문제되지 없다. 대부분의 높은 수준의 응용 프로그램이라면 문자열이나 int, long과 같은 원시 데이터 타입보다는 구조체 데이터를 읽고 쓰도록 되어 있다.

 유저 정보를 저장하고 읽는 간단한 프로그램을 작성한다고 가정해보자. 하나의 유저를 나타내기 위해서 필요한 정보는 다음과 같다고 할 때,

이름
나이
성별
취미

 프로그래머는 대략 다음과 같은 구조체를 사용할 것이다. 구조체는 데이터를 레코드 단위로 관리할 수 있도록 도와주기 때문이다.

struct userInfo
{
  char name[28];
  int  age;
  int  sex;
  char hobb6[28];
};

 그럼 위의 구조체 정보를 저장하는 간단한 유저정보 관리 프로그램을 만들어 보도록 하자. 제대로 만드려고 하면, 각 구조체 변수 데이터를 입력 받기 위한 인터페이스까지 만들어야 겠지만 생략하도록 하겠다. 이 프로그램은 뒷 부분에서 사용자 입력을 받을 수 있도록 확장될 것이다.

 테스트를 위해서 읽기와 쓰기를 전담하는 2개의 프로그램을 작성할 것이다. 우선 쓰기 프로그램이다. 이 프로그램의 이름은 UserInfoWrite.c 로 하겠다.

#include <stdlib.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <string.h>
#include <stdio.h>

struct userInfo
{
  char name[28];
  int age;
  int sex;
  char hobby[28];
};

void makeUserInfo(struct userInfo *uinfo,
  char *name,  // 이름
  int age,     // 나이
  int sex,     // 성 (남: 0, 여: 1)
  char *hobby) // 취미
{
  memset((void *)uinfo, 0x00, sizeof(struct userInfo));
  strcpy(uinfo->name, name);
  uinfo->age = age;
  uinfo->sex = sex;
  strcpy(uinfo->hobby, hobby);
}

int main()
{
  int fd;
  struct userInfo myAddrBook;
  fd = open("hello.txt", O_CREAT|O_WRONLY, S_IRUSR|S_IWUSR|S_IRGRP|S_IWGRP);
  if (fd < 0)
  {
    perror("file open error");
    return 1;
  }

  makeUserInfo((void *)&myAddrBook, "yundream", 19, 0, "프로그래밍");
  write(fd, (void *)&myAddrBook, sizeof(myAddrBook));

  makeUserInfo((void *)&myAddrBook, "hello", 22, 1, "게임");
  write(fd, (void *)&myAddrBook, sizeof(myAddrBook));

  makeUserInfo((void *)&myAddrBook, "드라고너", 33, 1, "사냥");
  write(fd, (void *)&myAddrBook, sizeof(myAddrBook));

  close(fd);
  return 0;
}

 유저 정보와 유저 정보 구조체인 userInfo 를 넘기면, 구조체를 채우는 makeUserInfo 라는 함수를 만들었다. 현재는 프로그램 상에 직접 유저 정보를 집어 넣었지만 나중에는 키보드로 입력받을 수 있도록 할 것이다.

 Line 40 ~ 47에서 유저 정보 구조체 myAddrBook 을 파일에 쓰고 있다. int형 데이터, char형 데이터를 쓰는 것과 다를게 없음을 알 수 있다. 컴퓨터의 입장에서는 int형 데이터나 char 형 데이터나 비트의 나열일 뿐임으로 근본적으로 다를게 없기 때문이다. 몇 바이트의 정보를 저장할 것인지에 대한 저장크기에만 차이가 있을 뿐이다.

 다음은 hello.txt에 저장된 유저 정보를 읽어들여서 출력하는 프로그램이다. 프로그램의 이름은 UserInfoRead.c 로 하겠다.

#include <stdlib.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <string.h>
#include <stdio.h>

struct userInfo
{
  char name[28];
  int age;
  int sex;
  char hobby[28];
};

int main()
{
  int fd;
  struct userInfo myAddrBook;
  int dataSize;
  fd = open("hello.txt", O_RDONLY);
  if (fd < 0)
  {
    perror("file open error");
    return 1;
  }

  dataSize = sizeof(myAddrBook);
  printf("User Info =====================\n\n");
  while(read(fd, (void *)&myAddrBook, dataSize) == dataSize)
  {
    printf("name  : %s\n", myAddrBook.name);
    printf("age   : %d\n", myAddrBook.age);
    printf("sex   : %d\n", myAddrBook.sex);
    printf("hobby : %s\n", myAddrBook.hobby);
    printf("===============================\n");
  }
  close(fd);
  return 0;
}

 데이터를 읽기만 할 것이기 때문에, O_RDONLY 를 사용했다. 다음 while문을 돌면서 userInfo 구조체의 크기 만큼, 파일로 부터 데이터를 읽어들여서 myAddrBook에 저장하고 있음을 알 수 있다.


 - 다음 포스트에 이어서...

2012년 12월 5일 수요일

리눅스 시스템 프로그래밍 : 03 입력과 출력(2)


5. 파일에서 읽기

 파일을 성공적으로 열었다면, 이제 읽거나 쓰는 등의 작업을 하면 된다. 여기에서는 파일을 읽는 법에 대해서 알아보도록 할 것이다. 우선 다음과 같은 내용의 샘플 파일을 하나 준비하도록 하자. 우리는 아래의 파일의 내용을 읽어서 화면에 출력하는 프로그램을 작성하는 것으로 파일 읽는 법에 대해서 배울 것이다. 파일의 이름은 fly.txt로 하겠다.

Fly me to the moon And let me play among the stars
Let me see what spring is like on Jupiter and Mars
In other words hold my hand
In other words darling kiss me

 - 'fly me to the moon' 가사 중 일부분이다.

 파일을 읽기 위해서는 당연히 읽기 전용 혹은 읽기/쓰기 상태로 파일을 열어야 한다. 여기에서는 읽기 전용 모드로 파일을 열도록 할 것이다. 만들어진 파일을 여는 것이기 때문에 O_CREAT는 필요 없으며, 파일을 생성하는 것이 아니기 때문에 모드 인자 역시 필요 없다. open 함수는 다음과 같이 사용할 수 있을 것이다.

  fd = open("fly.txt", O_RDONLY);
  if (fd < 0)
  {
    ...
  }

 성공적으로 파일을 열었다면 fd는 0보다 큰 수가 리턴 되었을 것이고, - 대부분의 경우 2보다 큰 수가 리턴 될 것이다. 이유는 아래에서 설명할 것이다 - 리턴 받은 정수를 파일 지정 번호로 사용하게 된다. 우리는 이 파일 지정 번호를 이용해서 파일의 내용을 읽게 된다.

   5.1 read 시스템 콜

 열린 파일로부터 데이터를 읽기 위해서 제공하는 시스템 함수가 read 이다. 이 함수는 인자로 주어진 파일 지정 번호가 가리키는 파일로부터, 지정된 크기 만큼의 데이터를 읽게 된다. 다음은 read 함수의 원형이다.

#include <unistd.h>

size_t read(int fd, void *buf, size_t count);
 
  1. fd : open 으로 열린 파일을 가리키는 파일 지정 번호
  2. buf : 읽은 데이터를 저장할 공간
  3. count : 읽을 데이터의 크기로 byte 단위

 함수는 단순하며 직관적이다. read 함수는 성공적으로 실행될 경우 0보다 큰 수를 리턴 한다. 파일의 끝에 다다라서 더 이상 읽을 데이터가 없다면 0을 리턴 한다. read 함수를 이용하는 일반적인 방법은 루프를 돌면서 리턴 값이 0이 될 때까지 - 즉 파일의 끝을 만날 때까지 - 데이터를 읽는 것이다. 다음과 같은 형태로 사용할 수 있을 것이다.

int readn = 0;
int fd;
char buf[80];
fd = open(...);

memset(buf, 0x00, 80);
while( (readn = read(fd, buf, 79) )
{
  // 읽은 데이터가 있는 buf를 이용해서 필요한 작업을 한다.
  memset(buf, 0x00, 80);
}

 주의해야 할 점은 데이터가 저장되는 buf를 memset 함수를 이용해서 초기화 시켜줘야 한다는 점이다. read 함수는 count만큼 데이터를 읽어들여서 buf에 복사하기만 할 뿐, 내용을 초기화 시키기 않기 때문이다. 예를 들어 이전에 79byte를 읽어들였고, 이번에 읽어들인 데이터가 20byte였다면, 21byte 이후에 이전 데이터가 그대로 남아 있어서 잘못 처리할 수 있기 때문이다. 물론 read 의 리턴 값을 이용해서 20byte를 읽어 왔다는 것을 알 수 있으므로 주의해서 처리하면 되긴 하겠지만 실수할 만한 여지는 미리 제거하는게 좋을 것이다.

 아래의 프로그램을 실행시켜 보기 바란다. 프로그램의 이름은 fly.c로 하자.

#include <stdlib.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

#define MAXLEN 80
int main()
{
  int fd;
  int readn = 0;
  char buf[MAXLEN];
  fd = open("fly.txt", O_RDONLY);
  if (fd < 0)
  {
    perror("file open error:");
    return 1;
  }
  memset(buf, 0x00, MAXLEN);
  while( (readn = read(fd, buf, MAXLEN-1 )) > 0)
  {
    printf("%s", buf);
  }
}
 
 프로그램을 실행시켜 보면, 마지막에 다음과 같이 이전에 읽어들인 값이 출력되는 것을 볼 수 있을 것이다.

Fly me to the moon And let me play among the stars
Let me see what spring is like on Jupiter and Mars
In other words hold my hand
In other words darling kiss me
on Jupiter and Mars
In other words hold my hand
...

 이제 21줄 다음에 memset(buf, 0x00, MAXLEN); 을 추가하고나서 다시 실행시켜 보도록 하자. 문제 없이 깔끔하게 출력되는걸 확인할 수 있을 것이다.

 또 하나 코드에서 궁금한 점이 있을 것이다. read 에서 버퍼의 최대 크기인 MAXLEN 만큼을 읽어들이지 않고 MAXLEN-1 만큼을 읽어들이는 점이다. 이는 역시 버퍼의 크기를 넘어서서 데이터를 읽어버리는 만약의 실수를 막기 위함이다. printf 함수의 경우 널문자('\0')를 만나기 전까지 데이터를 읽어들이게 된다. 버퍼를 가득채워서 읽어들였는데, 버퍼메모리 영역의 마지막이 '\0'이 아닐 경우 끝이 아니라고 판단해서, '\0'을 만날때까지 메모리영역을 벗어나서 계속 읽어 버리는 문제가 발생할 수 있기 때문이다. 그러하니 버퍼의 마지막 라인을 '\0'으로 만들어 버리는게 깔끔하다.

  01 ...  89 80
 +-------+--+--+---------------------------+
 | ..... |  |  | '\0'이 아닌 알 수 없는 값 |
 +-------+--+--+---------------------------+
 |<--- buf --->|

 이 경우에도 읽어들인 데이터의 크기를 알 수 있기 때문에 snprintf()와 같은 함수를 이용해서 문제를 해결할 수 있을 것이다. 그렇지만 가능한 문제 발생 여지를 없애는 쪽으로 코딩을 하는게 좋을 것이다.

 그렇다고 해서, 모든 경우에 있어서 문제가 되는건 아니다. 파일로부터 읽어들일 데이터가 char, int 와 같은 원시데이터 타입일 경우에는 크기가 명확히 명시되므로 위에서와 같은 초기화 관련된 문제가 발생하지 않는다.

   5.2 버퍼 공간의 크기

 buffer가 사용되는 일반적인 이유는 잡음을 없애고 성능을 높이기 위함이다. 읽어들일 데이터가 1024 만큼이 있다고 가정해보자. 버퍼의 크기를 1로 잡았다면, read 함수를 1024번 호출해야 될것이다. 만약 버퍼의 크기를 512로 잡는다면, 단 2번만 read 함수를 호출하면 될 것이다. 후자가 더 효율적일 거라는 것은 분명하다.

 그렇다고 해서 무작정 메모리를 크게 잡는 것도 낭비다. 시간과 비용이 관련된 대부분의 현상이 그렇듯이 어느정도 크기가 지나면 성능의 증가폭이 줄어드는 지점이 오기 때문이다. 적당한 선에서 트레이드오프 해야할 필요가 있다.

 어떤 데이터를 처리하느냐에 따라 다르겠지만 512byte나 1024byte정도의 크기로 하는게 무난하다고 알려져 있다.

6. 파일에 쓰기

 파일에 데이터를 쓰기 위해서는 쓰기 전용 혹은 읽기/쓰기 가능 모드로 열어야 한다. 리눅스 커널은 쓰기 요청을 위한 write 함수를 제공한다.

#include <unistd.h>

ssize_t write(int fd, const void *buf, size_t count);
 
 이 함수는 count 크기 만큼의 buf 에 있는 내용을 파일 지정 번호 fd 가 가리키는 파일에 쓸 것을 커널에 요청한다. 성공한 경우 쓴 byte 크기 만큼을 리턴한다.

 다음은 data.txt 파일을 열어서 int형 데이터를 쓰는 프로그램이다. 이 프로그램의 이름은 write.c로 하겠다.

#include <fcntl.h>
#include <unistd.h>
#include <stdio.h>
#include <string.h>

int main()
{
    int fd;
    int i;
    int wdata = 0;
    int wsize = 0;
    fd = open("data.txt", O_CREAT|O_WRONLY);
    if (fd < 0)
    {
        perror("file open error");
        return 1;
    }

    for (i = 0; i < 100; i++)
    {
        wdata = i * 2;
        wsize = write(fd, (void *)&wdata, sizeof(int));
        printf("Write %d (%d byte)\n", wdata, wsize);
    }
    close(fd);
}

 22줄을 주의깊게 살펴보도록 하자. fd 에 int형 변수, wdata 값을 쓰려고 하고 있다. wdata 는 int형 데이터이기 때문에, void *형으로 형 변환을 했다. 마지막으로 sizeof 함수를 이용해서 쓰고자 하는 데이터의 크기를 구해서, write의 3번째 인자로 되돌려 줬다. int 데이터 타입의 크기는 4byte라는 것을 이미 알고 있기 때문에, sizeof를 쓰지 않고 4를 직접 명시해도 될 것이다.

 그러나 어떤 운영체제와 컴파일러의 환경에 따라서 int가 2byte 혹은 8byte가 되는 경우도 있다. 그러므로 이식성을 고려한다면 sizeof 함수를 이용해서 데이터 타입의 크기를 얻어내는 방법을 사용하는 것을 권장한다.

 프로그램을 컴파일 하고 실행시키면 다음과 같은 결과를 볼 수 있을 것이다.

# gcc -o write write.c
# ./write
Write 0 (4 byte)
Write 2 (4 byte)
Write 4 (4 byte)
Write 6 (4 byte)
Write 8 (4 byte)
... 
 
 ls로 data.txt 파일이 생성된 것을 볼 수 있을 것이다. 이 파일의 내용을 살펴보기 위해서 vi 로 열어도 내용을 알아볼 수는 없을 것이다. 이 파일의 내용은 ASCII printable 데이터 - 흔히 말하는 문자데이터 - 가 아니기 때문이다.

7. 파일 닫기

 열린 파일을 더 이상 쓰지 않는다면, 닫아주어야 한다. 그렇지 않을 경우 프로그램이 종료될 때까지, 계속 남아서 컴퓨터 시스템의 자원을 소비하게 된다. 파일의 종료는 close 함수를 이용하면 된다.

#include <unistd.h>

int close(int fd);


 - 다음 포스트에 이어서...

2012년 11월 30일 금요일

리눅스 시스템 프로그래밍 : 03 입력과 출력(1)


1. 소개

 기계는 사용자의 입력을 받아서, 프로그래밍 되어 있는 대로 일을 하고 그 결과물을 출력한다. 믹서기는 사과를 입력 받고 버튼을 누르면, 프로그래밍 되어 있는 대로 모터를 돌려서 사과를 잘개 쪼개고 그 결과물로 사과쥬스를 출력한다. 컴퓨터는 정보를 처리하기 위한 기계로 입력을 받아서 처리하고 그 결과를 출력한다는 점에서 봤을 때, 근본적으로 믹서와 다를 바가 없다. 믹서와 다른 점이라면 입력으로 사과 대신 (비트로 이루어진)정보를 입력 받아서 처리하고 그 결과물로 정보를 출력한다는 점 정도일 것이다.

 여러분은 이미 컴퓨터 시스템은 키보드를 통해서 입력받은 데이터를 프로그램에 넘겨서 처리하고 그 결과물을 모니터로 출력하고 있다는 것을 알고 있을 것이다. 처리하고자 하는 데이터의 종류에 따라서 입력기기가 마우스나 펜, 터치 스크린이 되고, 출력기기 역시 파일, 프린터, 테이프 등이 될 것이다.

 이번 장에서는 컴퓨터 시스템에서의 입력과 출력을 제어하는 방법에 대해서 알아볼 것이다.

2. 모든 것은 파일이다

 유닉스에서는 모든 것을 파일로 취급한다. 하드디스크에 존재하는 파일, 디렉토리는 물론이고 네트워크 카드, 사운드 카드, 키보드, 마우스, 하드디스크 그 자체 까지 모두 파일로 취급한다. 유닉스 시스템을 처음 접할 때 꽤나 혼동되는 부분이기도 하다. 윈도우에는 파일은 단지 하드디스크 상에 존재하는 논리적인 정보의 집합을 그 대상으로 하기 때문이다. 예를 들자면 하드디스크는 C: D:와 같은 파일이 아닌 장치로 인식한다. 그러나 유닉스 시스템에서는 장치도 파일로 취급된다. 리눅스도 유닉스와 동일한 파일시스템을 가지고 있으므로, 리눅스를 예로 들어서 설명하겠다. 리눅스에서 하드디스크는 /dev/hda1, /dev/hda2 이런식으로 하드디스크상의 파일로 존재한다. 뿐만 아니다. 사운드 카드는 /dev/dsp, 프린트는 /dev/lp, cdrom은 /dev/cdrom 의 이름을 가진 파일로 존재한다.

 일반 사용자의 입장에서 장치를 파일로 인식하는 것이 불합리해 보일 수 있다. 그러나 개발자 입장에서는 매우 합리적인 방법이다. 모든 장치라는 것은 입력을 받아들여서 출력하는 매커니즘을 가지는데, 이는 파일의 매커니즘과 완전히 동일하기 때문으로 파일을 다루는 것과 동일한 방식으로 다른 장치들도 접근할 수 있음을 의미한다. 사운드 카드를 예로 든다면, test.wav 파일을 읽어서 /dev/dsp에 쓴다는 식으로 사운드를 플레이 할 수 있다. 실제로 프로그래밍 할 때도 일반 파일을 읽고 쓰는 것처럼 장치들에 접근할 수 있다. 물론 일반 파일들에 읽고 쓰는 것 보다는 약간 복잡하긴 하지만 원리적으로는 동일하다.

3. 파일의 종류

 위에서 예상했겠지만 파일이라고 해서 다 같은 파일은 아니다. 일반적으로 알고 있는 비트 데이터를 저장한 파일이 있는가 하면, 장치와 대응되는 파일도 있다. 내부 통신과 외부 통신을 위한 소켓파일(리눅스는 네트워크 통신도 파일을 통해서 한다), 파이프와 대응되는 파일, 디렉토리와 대응되는 파일 등이 있다. 예컨데 모든 것이 파일이다.

 리눅스에서는 ls 명령을 이용해서 이러한 파일의 종류를 알아낼 수 있다.

# ls -al
drwxr-xr-x 12 root root       13820 2007-11-12 22:19 .
drwxr-xr-x 21 root root        4096 2007-10-31 23:47 ..
drwxr-xr-x  2 root root         100 2007-11-13 06:45 .initramfs
-rw-r--r--  1 root root           0 2007-11-13 06:45 .initramfs-tools
drwxr-xr-x  3 root root          60 2007-11-13 06:45 .static
drwxr-xr-x  5 root root         120 2007-11-12 22:19 .udev
lrwxrwxrwx  1 root root          13 2007-11-13 06:45 MAKEDEV -> /sbin/MAKEDEV
crw-rw----  1 root root     10,  63 2007-11-12 21:46 acpi
crw-rw----  1 root audio    14,  12 2007-11-12 21:46 adsp
crw-rw----  1 root audio    14,   4 2007-11-12 21:46 audio
drwxr-xr-x  3 root root          60 2007-11-13 06:45 bus
lrwxrwxrwx  1 root root           3 2007-11-13 06:45 cdrom -> hda


 ls 의 가장 앞 필드의 첫 문자가 파일의 종류를 나타낸다. 아래는 ls 를 통해서 알아낼 수 있는 파일의 종류이다. 파일들은 아래의 종류 중 하나에 포함된다. pipe, 링크, 소켓 등에 대해서는 나중에 자세히 언급할 것이다. 우선은 아래와 같은 다양한 종류의 파일이 있다는 것만 이해하고 넘어가도록 하자.

-
일반파일
txt, jpg, wav, pdf 등 ... 
d
디렉토리
디렉토리
l
링크
심볼릭 링크 또는 하드 링크
c
장치
프린터, 사운드 카드, CD ROM 등의 장치
s
소켓
프로세스 간 통신에 사용
p
파이프
파이프

4. 파일 열기

 파일을 다루는 기본적인 흐름은 다음과 같다.

  1. 파일을 연다(open).
  2. 데이터를 읽거나(read), 데이터를 쓴다(write).
  3. 파일을 닫는다(close).

 가장 먼저 해야할 일이 파일을 open하는 것임을 알 수 있다. 이것은 커널에게 파일을 가지고 작업할 수 있도록 요청하는 것으로, 커널은 여러 가지 조건을 판단해서 파일을 open 해줄 것인지 아닌지를 결정하고, 그 결과를 open을 요청한 프로세스에게 리턴한다.

 파일을 오픈해 줄것인지 아닌지를 결정하는 데에는 다음과 같은 이유가 있다.
  1. 실제로 존재하는 파일인지 여부 확인
  2. 존재하지 않는 파일인 경우 새로 파일을 생성할 것인지 여부 결정
  3. 파일을 쓸 수 있는 권한이 있는지 확인 :
    리눅스는 다중 사용자 운영체제로 파일을 비롯한 모든 자원에 대한 접근 권한이 설정되어 있다. 따라서 해당 파일을 사용할 수 있는 권한이 있는지 확인해야 한다.


  4.1 open 시스템콜을 이용한 파일 열기

 파일 작업을 하기로 마음을 먹었다면, 커널에 정해진 파일을 열 수 있도록 허용해 달라고 요청을 해야 할 것이다. 커널에 요청을 할 수 있도록 지원되는 함수를 시스템 콜(혹은 시스템 함수)라고 언급했던 것을 기억하고 있을 것이다. 리눅스는 파일 오픈과 관련된 요청을 위해서 open 이라는 시스템 함수를 제공한다.

 open함수는 다음과 같이 선언되어 있다.

#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

int open(const char *pathname, int flags);
int open(const char *pathname, int flags, mode_t mode)

pathname : 열기를 요청하는 파일이다. 상대 경로 혹은 절대 경로를 지정할 수 있다.
flags : 어떤 방식으로 열 것인지를 결정하기 위해서 사용하며, bitwise연산을 이용해서 다양한 방식으로 조합할 수 있다. 다음은 대표적으로 사용되는 flag 들이다.
  • O_RDONLY
    읽기 전용으로 파일을 연다. 쓸 수 없다.
  • O_WRONLY
    쓰기 전용으로 파일을 연다.
  • O_RDWR
    읽기와 쓰기 모두 가능하도록 파일을 연다.
  • O_CREAT
    파일이 존재하지 않을 경우 파일을 생성한다.
  • O_EXCL
    O_CREAT를 써서 파일을 오픈 할 경우, 이미 파일이 존재한다면 error를 리턴하게 한다. 파일을 덮어쓰거나 하는 실수를 방지하기 위한 용도로 사용할 수 있다.

mode : 파일의 권한을 결정하기 위해서 사용하며, 생략이 가능하다. 파일이 생성되면 파일에 대한 소유자와 그룹은 자신이 된다. 이 인자를 사용하면 owner(사용자), group(그룹), other(타인) 각각에 대해서 읽기, 쓰기, 실행 권한을 부여할 수 있다. 역시 bitwise 연산을 이용해서 다양한 조합이 가능하다.
  • S_IRWXU
    00700 모드로 파일 소유자에게 읽기, 쓰기, 쓰기 실행권한을 준다.
  • S_IRUSR
    00400 으로 사용자에게 읽기 권한을 준다.
  • S_IWUSR
    00200 으로 사용자에게 쓰기 권한을 준다.
  • S_IXUSR
    00100 으로 사용자에게 실행 권한을 준다.
  • S_IRWXG
    00070 으로 그룹에게 읽기, 쓰기, 실행 권한을 준다.
  • S_IRGRP
    00040 으로 그룹에게 읽기권한을 준다.
  • S_IWGRP
    00020 으로 그룹에게 쓰기권한을 준다.
  • S_IXGRP
    00010 으로 그룹에게 실행권한을 준다.
  • S_IRWXO
    00007 으로 기타 사용자 에게 읽기, 쓰기, 실행 권한을 준다.
  • S_IROTH
    00004 으로 기타 사용자 에게 읽기 권한을 준다.
  • S_IWOTH
    00002 으로 기타 사용자 에게 쓰기 권한을 준다.
  • S_IXOTH
    00001 으로 기타 사용자 에게 실행 권한을 준다.

 예를 들자면 다음과 같은 방식으로 파일을 열 수 있을 것이다.

// 파일이름 hello.txt 에 데이터를 (단지)쓰기 위해서 연다.
// 파일이 없을 경우 생성하며
// 권한은 640 으로 한다.
open("hello.txt", O_CREAT|O_WRONLY, S_IRUSR|S_IWUSR|S_IRGRP|S_IWGRP);

 실제로 위의 권한으로 파일을 오픈하는 프로그램을 만들어 보도록 하자. 아래의 프로그램은 단지 파일을 열기만 할 뿐이지만 성공적으로 파일을 생성할 것이다. 프로그램의 이름은 hello.c 로 하겠다. 프로그램의 작성과 실행은 yundram계정을 이용했다.

#include <stdlib.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

int main()
{
  int fd;
  fd = open("hello.txt", O_CREAT|O_WRONLY, S_IRUSR|S_IWUSR|S_IRGRP|S_IWGRP);
}

 ls(1)를 이용해서 hello.txt를 확인해 보도록하자.

yundream@yundream:~$ ls -al hello.txt
-rw-r----- 1 yundream yundream 0 2007-11-20 20:23 hello.txt

 소유자과 그룹이 yundream이고 640의 권한을 가지는 파일이 생성되었음을 알 수 있다. 파일을 열기만 했을 뿐, 아무런 작업을 하지 않았기 때문의 파일의 크기는 0이다.

  4.2 file descriptor

 open 함수를 다시 보도록 하자. open 함수는 리턴 결과로 다루게 될 파일의 이름이 아닌 int형 정수를 넘겨주는 것을 알 수 있다. 이 int형 정수가 바로 파일을 가리키는 역할을 한다. 파일을 지정하기 때문에 'file descriptor' 혹은 '파일 지정번호' 라고 한다. 이것은 우리가 일반적으로 알고 있는 숫자가 아닌 열려진 파일객체를 가리키는 것임에 유의하기 바란다.

 open 을 이용해서 파일을 성공적으로 열었다면, 이후의 모든 쓰기/읽기 등의 작업은 파일이름 대신 파일지정번호를 이용하게 된다.

    +------+
    | FILE |<---- file discriptor = open
    |      |
    +------+
    open으로 리턴된 int형 정수는 file discriptor 로써, 열린 파일을 가리킨다.

 파일 지정번호는 0 이상이여야 한다. 0 보다 작은 경우는 어떤 이유로 파일을 여는 것이 실패했음을 의미한다. 위의 프로그램은 아래처럼 파일 오류까지 검사하는 좀 더 그럴듯한 프로그램으로 바꿀 수 있을 것이다.

  fd = open("hello.txt", O_CREAT|O_WRONLY, S_IRUSR|S_IWUSR|S_IRGRP|S_IWGRP);
  if (fd < 0)
  {
    perror("file open error:");
    return 1;
  }

다음 포스트에 이어서...

2012년 11월 27일 화요일

리눅스 시스템 프로그래밍 : 02 시스템 프로그래밍의 시작


1. 소개

 시스템 프로그래밍이란 시스템 프로그램을 작성하기 위한 일련의 과정을 의미한다. 시스템 프로그램은 시스템을 제어하는 프로그램이므로 결국 시스템 프로그래밍은 시스템을 알아가는 과정이라고 볼 수 있을 것이다. 시스템을 알아가는 과정이라고 해서, 컴퓨터의 CPU, Memory, 하드디스크 등의 시스템 자체에 대해서 공부할 필요는 없으니 미리 겁을 먹을 필요는 없다. 앞 장에서 설명했던 것처럼 운영체제가 제공하는 함수를 통해서, 시스템에 간접적으로 접근할 수 있기 때문이다.

 운영체제 덕분에 우리는 컴퓨터 시스템에 대한 대략적인 이해를 하고 있는 정도로도 컴퓨터 시스템을 다룰 수 있다. 물론 여러분이 임베디드 환경에서 작동하는 프로그램을 만들어야 한다면 컴퓨터 시스템에 대한 좀더 깊은 지식이 필요로 하겠지만, 대게의 경우 운영체제를 통한 간접적인 지식만으로도 시스템 프로그램을 작성하는데 문제가 생기는 경우는 없을 것이다.

2. 운영체제와 커널

 운영체제는 컴퓨터를 운용하는 특별한 종류의 프로그램이다. 그리고 운영체제의 핵심이라고 할 수 있는 부분이 바로 '커널' 이다. 커널은 컴퓨터 시스템을 제어하는 일, 그러니까 메모리를 관리하고, 디스크에 데이터를 읽고 쓰고, 프로그램을 실행시키고, 네트워크 카드, 사운드 카드, 그래픽 카드 등의 하드웨어 장치를 관리하는 일을 한다.

 학문적인 관점에서 보자면 운영체제란 바로 커널을 가리키는 것이다. 예를 들어 리눅스 운영체제는 리눅스 커널을 의미한다. 하지만 커널만을 가지고 할 수 있는 일은 그렇게 많지 않다. 커널 위에 shell, 운영자 관리 도구와 같은 필수적인 다른 프로그램이 있어야 비로서 컴퓨터를 제어할만한 환경이 갖추어진다. 이런 이유로 일반적인 관점에서 '커널 + 필수 프로그램' 까지를 운영체제라고 부르고 있다.

다음 그림은 컴퓨터 시스템과 커널, 프로그램의 관계를 보여주고 있다.


  • Linux Kernel은 컴퓨터 시스템의 자원을 직접 제어한다.
  • 프로그래머가 작성한 프로그램은 직접 시스템 자원을 제어할 수는 없다.
  • 프로그램은 커널에서 제공하는 함수를 이용해서 간접적으로 시스템 자원을 제어한다.

  2.1 Kernel space와 User space

 이렇게 커널이 할 수 있는 영역과 일반 응용 프로그램이 할 수 있는 영역이 구분이 되어 있다. 응용 프로그램은 직접적으로 시스템에 도달할 수 없으며, 리눅스 커널에 요청을 하는 방식으로 간접적으로 시스템을 제어할 수 있다. 이때 커널이 다루는 영역을 Kernel space라고 하고, 일반 응용 프로그램이 다루는 영역을 User space라고 한다.

Kernel space와 User space가 나뉘는 가장 큰 이유는 보안의 문제다. 아무 프로그램이나 시스템 자원을 직접 제어할 수 있다면, 심각한 문제가 발생할 수 있기 때문이다. 하드웨어와 프로그램의 중간에 리눅스 커널이 존재함으로써, 시스템 자원을 안전하고 효율적으로 사용할 수 있게 해준다. 응용 프로그램은 절대로 시스템에 바로 접근할 수 없다.

  2.2 응용 프로그램

 운영체제를 제외한 프로그램, 즉 운영체제 위에서 작동하는 모든 프로그램을 응용 프로그램이라고 한다. 시스템 프로그램과 네트워크 프로그램 혹은 게임 등 모든 프로그램이 응용 프로그램이다. 응용 프로그램이 실행되면, '시스템 콜'을 이용해서 운영체제로 컴퓨터 시스템의 자원의 사용을 요청하는 방식으로 원하는 작업을 수행하게 된다. 예를 들어 주소록을 저장하는 프로그램은 키보드를 사용할 수 있도록 커널에게 요청해서 사용자 입력을 받아들이고, 받아들인 입력을 임시로 저장하기 위해서 메모리 공간을 요청하고, 영구히 저장하기 위해서 디스크를 요청하는 과정을 거쳐서 주어진일을 하게 될 것이다.

  2.3 시스템 콜과 라이브러리

 '시스템 콜'이란 운영체제에게 요청할 수 있도록 만들어진 함수임을 알 수 있을 것이다. 이런 이유로 시스템 콜은 종종 시스템 함수라고 부르기도 한다. 리눅스 운영체제는 대략 190개 정도의 시스템 콜을 제공한다. 시스템 콜에 대한 자세한 목록은 Linux System Call Table 문서를 참고하기 바란다. 시스템 콜은 운영체제마다 다르기 때문에 만약 Windows에서 프로그래밍 하기를 원한다면, 그에 맞는 시스템 콜 목록이 필요하다.

 기본적으로는 시스템 콜만을 이용하는 것으로도 어떠한 프로그램이든지 만들어낼 수 있기는 하다. 그러나 시스템 콜만을 이용해서 프로그램을 작성하는 것은 보통 어려운 일이 아니다. 시스템 콜만을 가지고도 이미지를 읽어서 화면에 출력하는 프로그램을 작성할 수는 있기는 할 것이다. 하지만 개발에 너무 많은 시간이 걸리기 때문에 시스템 콜만을 가지고 개발하지는 않는다. 보통은 이미 만들어진 이미지 제어를 위한 함수를 사용해서 개발을 하게 된다. 이렇게 함수를 만들고, 용도에 맞게 모아 놓은 것을 라이브러리라고 한다. 함수 모음집이라고 할 수 있을 것이다. 이러한 라이브러리에는 그래픽 라이브러리, 수학 라이브러리 등 여러 종류가 있으며, 몇 개의 함수만 모아 놓은 간단한 라이브러리부터, 돈을 받고 판매하는 상업용 라이브러리까지 폭넓게 존재한다.

3. 리눅스 운영체제

 리눅스 운영체제는 커널과 필수 프로그램으로 이루어지며 일반적으로 배포판을 리눅스 운영체제라고 간주한다. 배포판은 리눅스를 쉽게 설치하고 관리할 수 있도록 커널, 관리 프로그램, 필수 응용 프로그램을 패키징 한 것이라고 보면 된다. 패키징 방법에 따라서 다양한 배포판이 존재하는데, RedHat, Ubuntu와 같은 것들이 널리 사용되는 배포판이다.

 이 문서는 여러분이 리눅스 운영체제를 어느 정도 사용할 줄 안다고 가정하고 만들어졌으므로 설치와 명령어의 사용과 같은 내용을 다루진 않을 것이다. 이하 리눅스 운영체제의 시스템영역에서의 상세한 내용은 시스템 프로그래밍을 진행하면서 조금씩 익혀나가도록 하겠다.

  3.1 리눅스 커널 구조

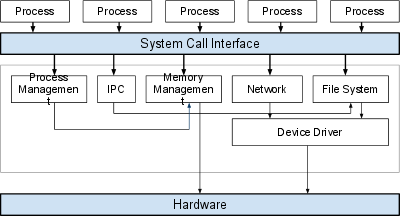
 리눅스 운영체제의 핵심인 커널은 다음과 같은 구조를 가진다.

이미지 참고 : 리눅스 시스템 프로그래밍 고영웅

  • Process는 프로그램의 실행 이미지로 프로그래밍 된 대로 필요한 일을 수행한다. 리눅스 커널은 User Space와 Kernel Space가 분리되어 있다. 그러므로 User Space의 프로세스는 직접 하드웨어 자원이나 기타 커널에서 제공하는 (IPC 와 같은) 서비스를 사용할 수 없다.
  • System Call은 커널에서 제공하는 요청 인터페이스 이다. 프로세스는 System Call을 이용해서 커널에 필요한 작업을 요청할 수 있다.
  • 커널은 Device Driver를 이용해서 각종 장치들을 제어하고, 프로세스를 스케쥴링하고, 메모리를 관리한다. 또한 프로세스 간 통신을 위한 IPC를 제공한다.
  • 컴퓨터 하드웨어는 다양한 장치들로 구성이 된다. 커널은 이러한 장치들을 제어해야 하며, 이러한 장치를 제어하기 위한 단위 코드를 Device Driver이라고 한다.

  3.2 리눅스 도움말 시스템

 '도움말 시스템'은 일반 사용자와 개발자를 막론하고 중요한 요소 중 하나이다. Windows 같은 경우에는 MSDN이라는 도움말 시스템을 제공한다. 개발자는 프로그램을 작성하는 도중에 모르는 함수나 기술적인 사항이 있다면, 온라인 혹은 오프라인 상에서 매우 상세한 도움말을 얻을 수 있다.

 운영체제가 성공을 하기 위해서는 개발자를 끌어들일 수 있어야 한다. 개발자를 끌어들이는 가장 좋은 방법은 좋은 개발 도구를 제공하는 것과 좋은 도움말 시스템을 제공하는 것이다. 이런 이유로 MS, Apple, IBM, HP, SUN 등의 회사들은 전략적으로 좋은 도움말 시스템을 제공하기 위해서 노력한다.

 유닉스 운영체제는 'man page'라는 도움말 시스템을 제공한다. 개발자는 다음과 같은 방법으로 함수나 명령어들에 대한 도움을 얻을 수 있다.

# man sprintf
 
 리눅스 역시 유닉스와 동일한 man page 제공한다. man page에 대한 자세한 내용은 man 도움말 문서를 참고하기 바란다.

  3.3 리눅스 표준 라이브러리

 리눅스는 자주 사용되는 기능을 구현한 표준 라이브러리 함수를 제공한다. 이 라이브러리에는 간단한 수학 연산, 문자열의 변환, 문자열 입출력, 병렬 처리, 파일 제어 등을 손쉽게 할 수 있도록 도와주는 함수를 제공한다. 이들 함수를 시스템 콜만을 이용해서 직접 만든다고 한다면 짧게는 100라인에서 길게는 수 천 라인까지 작성을 해야 하겠지만 표준 라이브러리 함수를 이용하면 몇 줄 내에서 해결할 수 있다.

 리눅스 시스템 프로그래밍은 시스템 콜과 표준 라이브러리 함수를 이용한 프로그래밍 영역이라고 보면 된다. 나머지는 응용 프로그래밍 영역으로, 시스템 콜과 표준 라이브러리에 덧붙여 다른 광범위한 영역의 라이브러리들을 사용하게 된다. 예를 들어, 게임을 만들고자 한다면 시스템 프로그래밍과 관련된 함수들외에 그래픽, 사운드, 이벤트 관련 라이브러리들을 사용하게 될 것이다.

 리눅스 표준 라이브러리에서 제공하는 함수들은 표준 라이브러리 man page를 참고하기 바란다. 그냥 참고만 하도록 하자. 굳이 익히려고 노력할 필요 없다. 문서를 읽어나가다 보면 자연스럽게 익히게 될 것이다.

리눅스 시스템 프로그래밍 : 01 Intro.


1. 시스템 프로그래밍의 중요성

 '현실에서는 시스템 프로그래밍 기술이 정말 중요한가?' 라는 얘기를 듣곤 한다. 프로그램을 만드는 프로그램을 이용해서 프로그램을 만드는 세상인데, '굳이 별로 재미도 없어 보이는 시스템 프로그래밍 쪽을 공부해야 하나?' 하는 것이다. 훌륭한 Visual 개발 도구와 잘 만들어진 라이브러리나 컴포넌트 기타 제작 도구들이 널려있다.

 이론상으로는 그럴 듯 하다. 실제로 그런 세계가 올지도 모른다. 컴퓨터에게 '은행 업무를 효율적으로 하기 위한 고객 관리 프로그램이 필요하거든 한번 만들어봐' 라고 하고 몇 가지 조건만 주면 그럴듯한 프로그램을 만들어내는 시대가 올지도 모른다.

 그러나 (프로그래머의 입장에서는)다행스럽게도 지금의 컴퓨터는 산업 전반에서 요구하는 모든 종류의 요청에 대해서 프로그램을 만들어낼 만큼 똑똑하지 못하다. 조금씩 인간이 개입하는 여지가 줄어들기는 하겠지만 당분간은 말 만으로 프로그램이 생성되어서, 프로그래머가 필요 없는 세상은 오지 않을 것 같다.

 결국 컴퓨터가 자동으로 할 수 없는 것은 인간이 책임질 수 밖에 없다. 이러한 영역이 주로 시스템 프로그래밍 영역이 된다. 메뉴, 창, 버튼, 입력 상자의 배치와 같은 프로그램의 외형은 컴퓨터가 자동으로 해낼 수 있지만 그 밑 단의 시스템 영역에서 이루어지는 데이터의 저장, 다중 작업, 데이터 통신과 같은 일들은 경험 있는 프로그래머가 반드시 필요하다. 여기에 최적화라는 컴퓨터가 자동으로 수행할 수 없는 영역도 있다. 최적화라는 것은 프로그램의 성능을 좀 더 높이기 위해서 시스템의 자원 사용을 최적화 하는 일련의 작업들이다. 메모리를 어떻게 사용할 것인지, 프로그램 간에 데이터 통신은 어떻게 할 것인지, 대량의 데이터를 병렬 처리 하기 위해서 어떤 시스템 통신 모델을 사용할 것 인지에 따라서 수십% 혹은 수백 %의 성능의 차이가 날 수 있는데, 이런 일은 자동화가 불가능한 영역이다. 역시 시스템에 대한 지식을 가진 경험 있는 시스템 프로그래머가 필요하다.

 결론은 이렇다. 아주 간단한 프로그램이 아니라 제대로 돌아가는 프로그램을 만들고자 한다면, 혹은 취미로 프로그램을 작성하고자 하는 생각 이 아니라면 시스템 프로그래밍은 선택 사항이 아닌 필수 사항이다.

2. 일반적인 프로그래밍 학습 과정

 공부에는 정도가 없다고 하지만 다음과 같은 순서로 프로그래밍을 학습한다면 효율이 좋을 것으로 생각된다.
  1. 프로그래밍 언어(Java, C, C++ 등)를 익힌다.
  2. 시스템 프로그래밍에 대하여 공부한다.
  3. 네트워크 프로그래밍에 대하여 공부한다.
  4. 네트워크 프로그래밍을 바탕으로 좀 더 깊은 수준의 시스템 프로그래밍에 대하여 공부한다.
  5. 효율적인 프로그래밍을 위하여 자료구조와 알고리즘에 대한 공부를 한다.
  6. 게임 및 보안 관련 프로그램을 제작하는 등의 일을 통하여 응용해 본다.

3. 운영체제와 시스템 프로그래밍

 시스템 프로그래밍이란 컴퓨터 시스템을 다루는 프로그래밍을 의미한다. 여기에서 컴퓨터 시스템이란 컴퓨터를 이루는 구성 요소들인 모니터, 키보드, 메모리, 하드디스크, NIC를 의미한다. 그렇다고 해서 프로그래머가 모니터, 키보드, 메모리와 같은 기계장치에 직접 명령을 내려야 하는 것은 아니다. 인간과 컴퓨터 사이에 운영체제가 존재하기 때문이다.  운영체제가 있는 덕분에 프로그래머는 컴퓨터 기계장치에 직접 명령을 내리지 않고, 운영체제를 통해서 간접적으로 명령을 내리는 정도로 컴퓨터 시스템을 제어할 수 있게 된다.
 

 은행 창구가 있는 덕분에 복잡한 금융거래를 간단하게 할 수 있는 것과 같은 이치다. 돈을 송금하는 과정은 여러 단계의 매우 복잡한 과정을 거쳐야 할 것이다. 그러나 고객은 그 과정을 알 필요 없다. 그냥 '이 돈을 어디 어디 계좌로 보내주세요' 라는 내용을 적은 명세표만 직원에게 주면 된다. 나머지 일은 창구 직원이 알아서 해준다.

 시스템 프로그래머에게 있어서 운영체제는 프로그래머와 컴퓨터 시스템 간의 창구 역할을 하는 프로그램으로 이해하면 될 것이다. 프로그래머가 운영체제에게 어떤 요청을 할 때에는 '이러한 일을 해주세요' 라고 명세표를 작성해야 할 것이다. 이러한 요청을 쉽게 하도록 하기 위해서 운영체제는 시스템 함수라는 것을 제공한다. 예를 들어, 리눅스 운영체제는 메모리할당과 관련되어서 malloc()이라는 시스템 함수를 제공한다. 그러면 프로그래머는 다음과 같은 방법으로 메모리 할당을 요청하게 된다.
malloc(2*1024*1024) // 2메가의 메모리 공간을 요청

 요청을 받은 운영체제는 복잡한 과정을 거쳐서 메모리를 할당하고, 메모리가 할당된 공간을 프로그래머에게 알려준다. 이제 프로그래머는 할당된 공간을 이용하기만 하면 된다.

 이러한 시스템으로의 명령은 안타깝게도 운영체제마다 약간의 차이가 있다. 윈도우와 리눅스가 다르고, 리눅스와 솔라리스가 또 다르다. 때문에 윈도우 시스템 프로그래밍 기술을 리눅스 시스템 프로그래밍을 하는데 이용하는 데에는 많은 어려움이 따른다. 물론 운영체제가 다르다고 해도, 작동 방식은 비슷하기 때문에 한쪽 운영체제의 시스템 프로그래밍 지식을 다른 운영체제에서 전혀 써먹을 수 없는 건 아니다. 많은 운영체제들이 Unix 운영체제를 그 기반으로 하고 있기 때문에 함수명이나 사용 방법, 기능이 비슷한 경우가 많기 때문이다. 하지만 여전히 어려운 것은 사실이다.

 그러므로 시스템 프로그래밍에 발을 들여놓으려고 한다면, 운영체제를 선택하는 것이 중요한 요소가 된다. 물론 여기에서는 여러분이 리눅스 운영체제를 선택했다고 가정할 것이다.

2012년 11월 20일 화요일

리눅스 C/C++ : 13장 Input / Output


 이번 포스트에서는 모든 응용분야를 통틀어서, 공통적으로 다루어지는 분야인 입력과 출력에 대해서 다음과 같이 알아보도록 할 것이다.

  • 표준입력, 표준출력, 표준에러
  • 형식화된 입출력
  • 파일로 부터의 입력과 출력 처리
  • exit

프로그램이 하는 일의 전부는 입력을 받아서 처리한 다음 그 결과를 출력하는데 있다고 보면 된다. 어떤 프로그램을 구현함에 있어서 가장 먼저 하는 일이, 프로그램이 하는 일을 담은 명세서를 작성하는 것인데, 명세서란 것이 결국은 어떤 데이터를 입력 받아서 어떻게 출력할 것 인지를 정의 하는 일이다. 예를 들자면 시스템 프로그램과 네트워크 프로그램의 5할이 입력과 관련된 일이고 3할이 문자열 처리와 관련된 것이라고 보면 된다. 그러므로 입/출력에 대해서 반드시 알고 넘어갈 필요가 있다.

1. 입출력 장치

 아마도 컴퓨터의 3가지 구성장치에 대해서 배운기억이 있을 것이다. 이들 구성요소는 다음과 같다.

  1. 중앙연산장치
  2. 입력장치
  3. 출력장치

 기본적으로 중앙연산장치를 제외한 모든 것은 입력장치 혹은 출력장치로 구분이 된다. 대표적인 입력장치는 키보드, 마우스, 터치패드, 카메라 등이 될 것이다. 출력장치는 모니터, 프린터, 사운드 카드를 예로 들 수 있다.

 어떤 형식으로든지 간에 데이터를 받아들이는 장치는 입력장치가 되고, 받아들인 데이터를 소리,문자, 이미지의 형태로 다시 표현해주는 장치를 출력장치라고 정의 할 수 있다. 키보드로 입력된 정보는 중앙연산장치에서 처리된 다음에 적당한 과정을 거쳐서 모니터로 출력되고, 필요한 경우 프린트를 이용해서 종이로 출력되거나 할 것이다.

2. 모든 입출력은 파일로 처리한다

 유닉스 운영체제는 모든 입출력과 관련된 장치는 파일과 동일하게 보고 처리를 한다. 하드디스크의 경우 C:, D:와 같이 다루어지는 것과는 달리, 유닉스는 장치파일이라는 특수한 파일 형태로 다른다. 뿐만 아니라 프린트, 사운드 카드 까지도 파일의 형태로 다룬다. 이러한 장치파일들은 /dev 디렉토리 밑에 존재한다. 예를 들어 윈도우즈에서 말하는 C: 드라이브는 /dev/hda1 과 같은 파일이름으로, 프린터기는 /dev/lp0 이라는 파일이름으로 존재한다.

 컴퓨터에 사용되는 장치를 파일의 개념으로 놓고 본다는 것은 윈도우즈환경을 주로 사용했던 유저에게는 그리 익숙하지 않을 것이다. 그러나 조금만 생각해 보면 적어도 개발자입장에서는 매우 합리적인 개념임을 알 수 있을 것이다. 파일과 마찬가지로 읽고, 쓴다라는 개념이 그대로 적용되며, 일반 파일에 사용되는 방법과 동일한 방식으로 다양한 종류의 장치를 다룰 수 있기 때문이다. 물론 각 장치들은 읽고 쓰기 위한 전용의 프로토콜을 사용하기 때문에 프로토콜에 대한 학습이 필요하긴 하지만 사용되는 함수 등은 일반 파일을 다룰 때와 동일하다고 보면 된다. 이렇게 모든 것을 파일로 다루게 됨으로써, 장치에 대한 별도의 학습없이도 일관성있게 프로그램을 작성할 수 있게 된다.

 하지만 여기에서는 다른 장치들에 대한 입출력을 다루지는 않을 것이다. 가장 기본이 되는 파일에 대한 입출력 만을 다룰 것이다.

3. file description

 "abc.txt" 라는 파일을 읽거나 쓰기 위해서는 파일을 open하는 과정을 거친다. 그러면, 운영체제는 파일을 쉽게 다룰 수 있도록 int 형의 숫자를 넘겨준다. 이후에 파일에 쓰거나 읽는 작업은 파일이름이 아닌 이 숫자를 통해서 이루어지게 된다. 이 숫자를 file description이라고 한다. 혹은 파일지시자라 부르기도 한다. 실제 프로그래밍 과정에서 파일지시자를 어떻게 사용하는지는 나중에 예제를 통해서 알아보도록 하겠다.

4. 표준입력, 표준출력, 표준에러

 운영체제에서 주어진 일을 하는 최소 단위는 프로세스라는 것을 알고 있을 것이다. 프로세스는 프로그램의 실행된 이미지로 운영체제의 메인 메모리에 위치한다.

 이렇게 프로그램이 실행되어서, 프로세스가 생성되면 프로세스는 컴퓨터의 여러가지 기본자원을 사용할 수 있게 된다. 이 기본자원에 3개의 파일이 포함되어 있다. 바로 입력과 출력, 에러를 담당하는 3개의 파일들이다. 이것들을 표준입력, 표준출력, 표준에러라고 한다.

  • 표준입력 : 키보드로부터 입력을 받기 위해서 사용한다.
  • 표준출력 : 모니터로 출력하기 위해서 사용된다.
  • 표준에러 : 에러도 역시 모니터를 통해서 출력 된다는 점에서는 표준출력과 마찬가지다. 그러나 어떠한 구분도 없다면, 화면에 출력 된 값이 정상적으로 처리된 메시지인지, 에러메시지 인지 확인할 수 없을 것이다. 때문에 표준에러라는 것을 따로 두어 구분할 수 있도록 하고 있다.

 이들 표준입/출력/에러 역시 파일의 형태로 다루어지며, 운영체제는 이를 위해서 예약된 숫자를 파일지시자로 할당한다. 표준입력은 0, 표준출력은 1, 표준에러는 2로 예약되어 있다.

 간단한 예를 들어서 설명해보도록 하겠다.
 
#include <unistd.h>
#include <string.h>

int main(int argc, char **argv)
{
  char data[80];
  char *msg = "Input Msg : ";
  memset(data, 0x00, 80);

  write(1, msg, strlen(msg));   // 1

  read(0, data, 80);            // 2
  write(1, data, strlen(data)); // 3
  write(2, "Error\n", 6);       // 4
} 
 
  1. "Input Msg"메시지를 모니터에 표준출력 한다.
  2. 표준입력을 통해서 데이터를 읽어들인다. 읽어들인 데이터는 data 에 복사한다.
  3. data에 복사된 내용을 data의 길이 만큼 모니터에 표준출력 한다.
  4. Error라는 메시지를 모니터에 표준에러형태로 출력한다. 

 이 프로그램을 실행시키면 다음과 같은 결과를 확인할 수 있을 것이다.
 
# ./write
Input Msg : hello world
hello world
Error
 
  • write(2) 이 함수는 파일지시자(첫번째 인자)가 가리키는 파일에 "쓰기" 위해서 사용한다.
  • read(2) 이 함수는 파일지시자가 가리키는 파일에서 데이터를 "읽기" 위해서 사용한다.

 표준입력과 표준출력을 이해하는 데에는 별 어려움이 없을 것이다. 그럼 표준에러와 표준출력을 어떻게 구분할 수 있느냐 하는 문제가 남는다.

 표준에러는 쉘의 재지향을 이용해서 따로 분리해서 읽을 수 있다. 재지향은 >을 쓰면 된다. - 2장 리눅스와 C언어참고 - 또한 2>와 같이 표준에러만을 분리해서 재지향 시킬 수가 있다. 여기에서 2가 바로 표준출력을 가리키는 파일지시자 번호다. 이제 다음과 같이 표준에러만 별도의 파일에 재지향 시켜보도록 하자.

# ./write 2> dump.log
Input Msg : hello world
hello world
# cat dump.log
Error

 표준에러가 모니터 화면이 아닌, dump.log 파일에 저장된 것을 확인할 수 있을 것이다. 이로써, 표준에러와 표준출력이 모니터를 출력방향으로 하고 있지만, 명백히 구분되는 것임을 이해했을 것이다.

5. 파일 입출력

 그러면 유닉스 프로그래밍에 있어서 가장 중요한 파일 입출력에 대해서 알아보도록 하겠다. 기본적으로는 표준입력/출력/에러를 다루는 방식과 동일 하다. 다른 점이 있다면, 표준입력 등은 운영체제가 알아서 열어주지만, 다른 파일들은 프로그래머가 함수를 이용해서 파일을 직접 열어주어야 한다는 점이다.

 해서 파일 입출력에는 read(2)와 write(2)외에 파일을 열기 위한 open(2)과 닫기 위한 close(2)가 사용된다. 원칙적으로는 이 네 가지의 함수만 있으면 거의 대부분의 파일과 관련된 작업을 할 수 있다. 이들 함수에 대한 자세한 설명은 (http://www.joinc.co.kr/modules/moniwiki/wiki.php/Site/system_programing/Book_LSP/ch03_Env)를 참고하길 바란다.

6. 예제 1 - 전형적인 파일 읽기 프로그램

 cat 이라는 프로그램을 알 것이다. 이 프로그램은 인자로 주어진 파일을 화면에 출력하는데, cat과 비슷한 프로그램을 만들어 보도록 하자. 이 프로그램의 이름은 mycat으로 하겠다.

#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <fcntl.h>

// 사용하기 쉽도록 표준입력,출력,에러를 다른 이름으로 정의 한다.
#define STDIN 0
#define STDOUT 1
#define STDERR 2

int main(int argc, char **argv)
{
    char *filename;
    int fd;
    int readn;
    char buf[80];

    // 이 프로그램이 실행되기 위해서는 파일이름을 인자로 받는다.
    // 그러므로 인자를 체크해주어야 한다.
    // 만약 인자가 부족하다면, 프로그램의 사용방법을 출력하고 종료한다.
    if (argc != 2)
    {
        printf("Usage : %s [file]\n", argv[0]);
        return 1;
    }

    // filename 이 argv[1] 을 가리킨다.
    // argv[1] 을 그대로 사용해도 되겠지만, 코드의 가독성을 위해서
    // 다른 변수이름을 사용하도록 했다.
    filename = argv[1];

    // 파일을 읽기전용 모드로 연다.
    fd = open(filename, O_RDONLY);
    // 에러 체크를 한다.
    if (fd < 0)
    {
        perror("file open err :");
        return 0;
    }

    // read 함수를 이용해서, 파일지시자로 부터 데이터를 읽어들인다.
    // read 함수는 읽어들인 데이터의 크기를 리턴한다.
    // 더이상 읽을 데이터가 없다면 0을 리턴하니, 그때 while 루프를 빠져나오면 된다.
    while((readn = read(fd, buf, 80)) > 0)
    {
        // 읽어들인 데이터의 크기 만큼을 화면에 출력한다.
        write(STDOUT, buf, readn);
    }
    close(fd);
    return 1;
}
 
 이 프로그램은 기존의 프로그램들과는 달리 꽤 완성된 모습을 보여주고 있다. 어떤 점에서 그런지 살펴보도록 하자.

  1. 프로그램의 실행인자를 검사하고 있다.
  2. 에러를 체크하고 있다.
    모든 함수는 리턴값을 이용해서 에러를 체크할 수 있도록 하고 있다. 견고한 프로그램을 만들기 위해서는 반드시 에러에 대한 처리를 해줘야 한다.
  3. main 함수도 실행결과를 값으로 리턴하고 있다.
    프로그램의 실행결과는 중요한 정보다. 프로그램이 성공했는지 실패했는지에 대한 정보를 이용해서 다른 일들을 할 수 있기 때문이다. 이는 여러개의 프로그램이 연속적으로 실행되는 배치작업에서 특히 중요하다. 유닉스 프로그램은 전통적으로 제대로 실행이 되었다면 0을 그렇지 않다면 0이 아닌 다른 수를 리턴한다.
  4. 가독성
    표준입력,출력,에러 등을 위해서 0,1,2등을 사용하는건 직관적이지 못하다. 직관적이지 못하다는 것은 프로그래머가 실수를 할 수 있음을 의미한다. define 문을 이용하면 가독성 좋은 직관적인 프로그램을 만들 수 있다.

 이제 이 프로그램을 컴파일 한다음에 실행시켜 보도록 하자. 프로그램의 이름은 mycat 이라고 하겠다. 내용이 길어서 실행결과는 생략했다.

# ./mycat mycat.c
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <fcntl.h>

#define STDIN 0
#define STDOUT 1
#define STDERR 2
....
....

 재지향을 이용하면 다음과 같은 응용도 가능 할 것이다.
 
# ./mycat mycat.c > mycat.bak

결과적으로 mycat.c 를 mycat.bak 라는 파일로 복사를 한 것과 같다.

7. 예제 2 - 표준입력으로 부터 읽어들이도록 해보자

 위에서 다루었던 예제 프로그램을 약간 수정해서, 표준입력으로부터 입력된 데이터를 출력하는 프로그램을 만들어 보도록 하자.
 
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <fcntl.h>

#define STDIN 0
#define STDOUT 1
#define STDERR 2

int main(int argc, char **argv)
{
    char *filename;
    int readn;
    char buf[80];

    while((readn = read(STDIN, buf, 80)) > 0)
    {
        // 읽어들인 데이터의 크기 만큼을 화면에 출력한다.
        write(STDOUT, buf, readn);
    }
    return 1;
}
 
 프로그램이 훨씬 간단해졌다. 표준입력은 프로세스가 생성될 때 자동으로 열린다. 덕분에 파일을 여는 등의 코드가 필요 없기 때문이다. 위 프로그램을 컴파일 한 다음에 실행시켜보도록 하자.

# ./mycat2
hello world
hello world
ok
ok

 키보드 입력을 받아들이고 엔터키를 누르면, 입력된 내용이 출력되는 것을 확인할 수 있을 것이다. Ctrl+D를 누르면 프로그램을 빠져나올 수 있다.

 혹은 파이프를 이용할 수도 있다. 파이프를 통해서 넘어오는 정보는 표준입력으로 읽을 수 있기 때문이다.

# cat mycat.2 | ./mycat2
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <fcntl.h>
...
...
 
 이렇게 파이프와 표준입력을 잘 사용하면, 복잡하게 파일을 열거나 하는 일 없이 다른 프로그램으로부터 생성된 문자열 등의 데이터를 표준입력으로 받아서 간단히 처리할 수 있다.

8. 파일 복사하기

 위의 파일 입출력작업은 키보드나 파일로부터 입력 받아서, 모니터로 표준출력 하는 것만 수행해보았다. 그렇다면 이제 표준출력이 아닌 파일로 출력 하는 방법에 대해서 알아보도록 하자.

 유닉스에서는 모니터나 파일이나 모두 동일하게 파일로 입력하기 때문에, 표준출력과 마찬가지로 write()함수를 이용해서, 파일로 쓸 수 있다. 다른 점이라면, 이미 열려있는 표준출력과는 다르게, 파일출력의 경우 쓰고자 하는 파일을 직접 열어주어야 한다는 것이다.

#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

// 사용하기 쉽도록 표준입력,출력,에러를 다른 이름으로 정의 한다.
#define STDIN 0
#define STDOUT 1
#define STDERR 2

int main(int argc, char **argv)
{
    char *orgfile, *dstfile;
    int rfd, wfd;
    int readn;
    char buf[80];

    // 인자로 원본파일과 복사파일 이름을 받는다.
    // src file이 dst file로 복사된다.
    if (argc != 3)
    {
        printf("Usage : %s [src file] [dst file]\n", argv[0]);
        return 1;
    }

    // orgfile 이 argv[1] 을, dstfile 이 argv[2] 를 가리킨다.
    // argv[1], argv[2] 을 그대로 사용해도 되겠지만, 코드의 가독성을 위해서
    // 다른 변수이름을 사용하도록 했다.
    orgfile = argv[1];
    dstfile = argv[2];

    // 원본 파일을 읽기전용 모드로 연다.
    rfd = open(orgfile, O_RDONLY);
    // 에러 체크를 한다.
    if (rfd < 0)
    {
        perror("org file open err :");
        return 0;
    }

    // 복사파일은 쓰기전용으로 연다.
    // 복사파일의 권한은 00700 즉 사용자에게 읽기,쓰기,실행 권한을 준 상태로 한다. 
    wfd = open(dstfile, O_WRONLY|O_CREAT,S_IRWXU);
    // 에러 체크를 한다.
    if (wfd < 0)
    {
        perror("dst file open err :");
        return 0;
    }
  
    // 원본파일로 부터 데이터를 읽은다음
    // 읽어들인 데이터의 크기만큼 복사파일에 쓴다.
    while((readn = read(rfd, buf, 80)) > 0)
    {
        write(wfd, buf, readn);
    }
    close(rfd);
    close(wfd);
    return 1;
}
 
 위 코드를 컴파일 한다음 테스트해보도록 하자.
 
# ./mycopy mycopy.c mycopy.bak